Dlaczego Time to First Byte jest wolny i co z tym zrobić
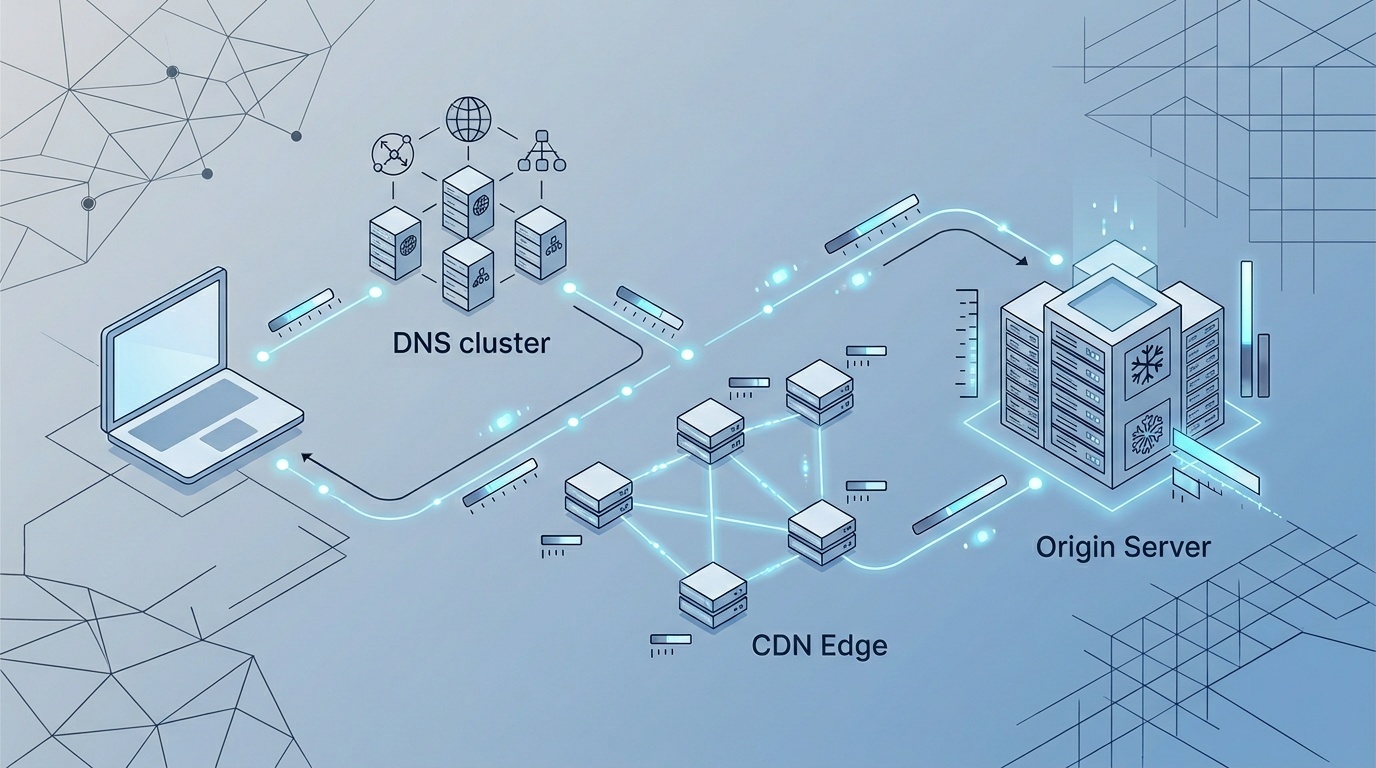
TTFB nie jest pojedynczym błędem. To widoczne opóźnienie powodowane przez DNS, zestawianie połączenia, routing CDN, pracę serwera, chybienia pamięci podręcznej, a czasem jedno wolne zapytanie do bazy danych.
Spis treści
- Zacznij od tego, co TTFB naprawdę mierzy
- Co uznaje się za wolny TTFB?
- Mierz w więcej niż jednym miejscu
- 1. Narzędzia deweloperskie przeglądarki
- 2. Testy syntetyczne z wielu regionów
- 3. Real user monitoring albo logi serwera
- Typowe przyczyny wolnego TTFB
- Twój HTML nie jest cachowany
- CDN cachuje tylko zasoby
- Serwer robi zbyt dużo przed odpowiedzią
- Zapytania do bazy danych są wolne lub nieprzewidywalne
- Aplikacja ma cold starts
- Przekierowania marnują pierwsze żądanie
- Praktyczna kolejność debugowania
- Krok 1: Testuj główny dokument, nie tylko całą stronę
- Krok 2: Porównaj regiony
- Krok 3: Sprawdź nagłówki odpowiedzi
- Krok 4: Sprawdź czasy origin
- Krok 5: Napraw największe potwierdzone opóźnienie
- Poprawki, które zwykle działają
- Cachuj publiczny HTML na krawędzi
- Przenieś niekrytyczną pracę poza ścieżkę żądania
- Ogranicz łańcuchy zależności backendu
- Umieść obliczenia bliżej użytkowników
- Utrzymuj przekierowania nudne
- Czego nie robić
- Spokojna wersja planu
Zacznij od tego, co TTFB naprawdę mierzy
Time to First Byte, zwykle skracane do TTFB, to czas między wysłaniem przez przeglądarkę żądania zasobu a otrzymaniem pierwszego bajtu odpowiedzi.
Brzmi to jak metryka serwera, ale nie jest to wyłącznie metryka serwera. TTFB obejmuje kilka kroków:
- wyszukiwanie DNS, jeśli nazwa hosta nie została jeszcze rozwiązana
- zestawianie połączenia TCP
- negocjację TLS dla HTTPS
- czas podróży żądania do serwera lub krawędzi CDN
- kolejkowanie i przetwarzanie na serwerze
- czas podróży odpowiedzi z powrotem do przeglądarki
Wysoki TTFB może więc oznaczać, że backend jest wolny. Może też oznaczać, że użytkownik jest daleko od origin, CDN jest źle skonfigurowany, cache stale nie trafia albo serwer zbyt długo decyduje, co wysłać.
Ma to znaczenie, ponieważ TTFB znajduje się blisko początku łańcucha ładowania. Jeśli dokument HTML dociera późno, przeglądarka późno odkrywa także CSS, JavaScript, fonty i obrazy. Możesz mieć świetną optymalizację front-endu, a strona i tak będzie wydawać się wolna, jeśli pierwsza odpowiedź z dokumentem trwa 1,5 sekundy.
Co uznaje się za wolny TTFB?
Nie ma jednej uniwersalnej liczby pasującej do każdej witryny, regionu i architektury. Praktyczne progi jednak pomagają.
Wytyczne Google web.dev klasyfikują dobry TTFB jako poniżej 800 ms, zakres 800–1800 ms jako wymagający poprawy, a powyżej 1800 ms jako słaby wynik. Dla dobrze cachowanej strony marketingowej serwowanej blisko użytkownika często można osiągnąć znacznie lepszy wynik. Dla złożonego uwierzytelnionego dashboardu wykonującego dynamiczną pracę akceptowalna wartość może być wyższa, ale nadal powinna dać się wyjaśnić.
Najważniejszym nawykiem jest segmentowanie tej liczby. Globalna średnia TTFB na poziomie 900 ms może ukrywać odpowiedź 150 ms dla użytkowników blisko krawędzi CDN i odpowiedź 2200 ms dla użytkowników w innym regionie. Podobnie strona główna może działać dobrze, podczas gdy wyszukiwanie, kategorie albo strony po zalogowaniu po cichu sprawiają problemy.
Mierz w więcej niż jednym miejscu
Nie diagnozuj TTFB na podstawie pojedynczego uruchomienia Lighthouse. Lighthouse jest przydatny, ale to jeden test z jednego środowiska. Jeśli dopiero uczysz się go interpretować, zacznij od spokojnej lektury o tym, jak czytać raport Lighthouse bez paniki — główna lekcja polega na oddzieleniu sygnałów laboratoryjnych od rzeczywistości w terenie.
Dla TTFB potrzebujesz co najmniej trzech perspektyw:
1. Narzędzia deweloperskie przeglądarki
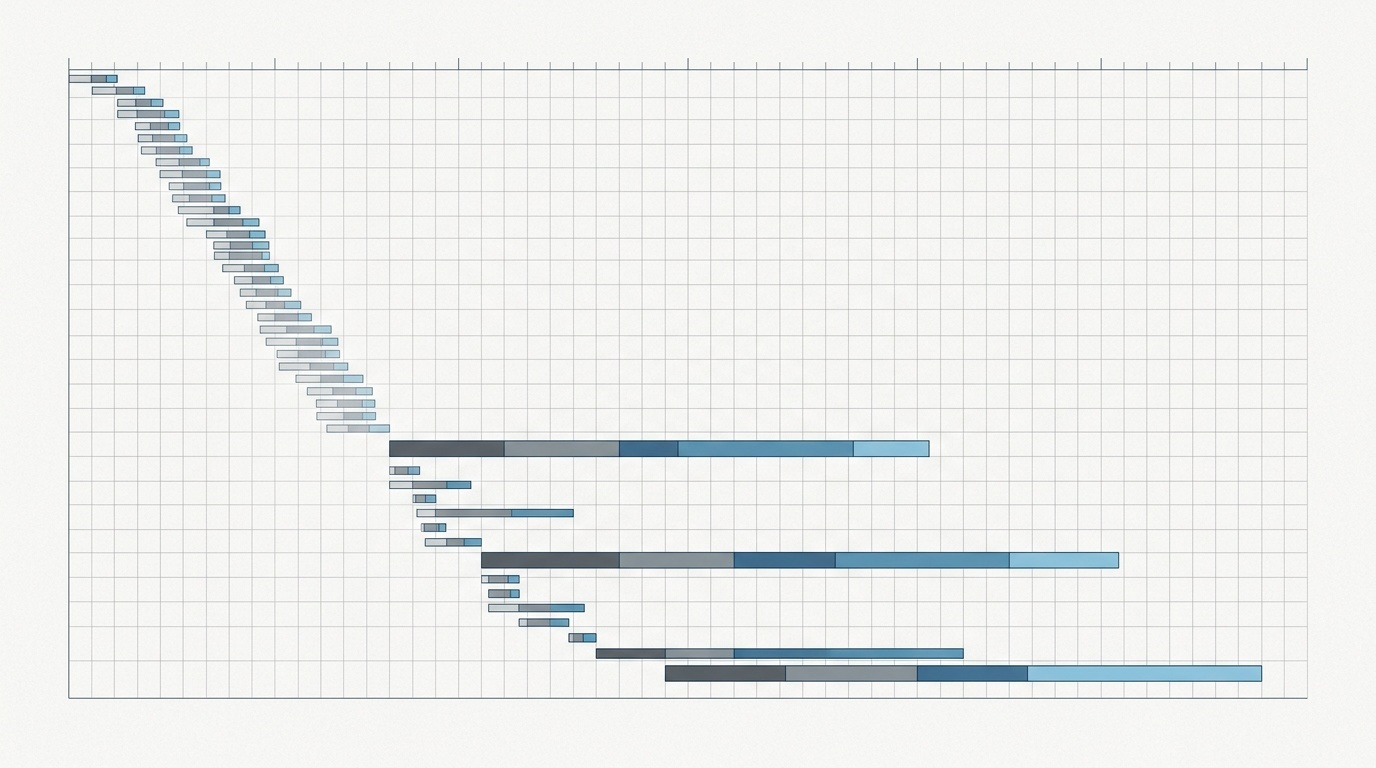
Otwórz panel Network, przeładuj stronę z wyłączonym cache i sprawdź główne żądanie dokumentu. Rozbicie czasów pokazuje fazy DNS, połączenia, TLS, oczekiwania i pobierania. Faza „waiting” często jest tym, co ludzie rozumieją jako czas backendu, choć może obejmować również opóźnienia upstream.
2. Testy syntetyczne z wielu regionów
Uruchom testy z lokalizacji bliskich użytkownikom i od nich odległych. Jeśli TTFB jest niski w jednym regionie, a wysoki w innym, zanim zaczniesz przepisywać kod aplikacji, podejrzewaj geografię, routing CDN, lokalizację origin albo pokrycie cache.
3. Real user monitoring albo logi serwera
Dane terenowe pokazują, czego doświadczają prawdziwi użytkownicy na różnych urządzeniach, sieciach i w różnych sesjach. Logi serwera mogą powiedzieć, czy origin wygenerował odpowiedź szybko. Różnica między TTFB obserwowanym po stronie klienta a czasem przetwarzania origin często wskazuje miejsce, w którym pojawiają się problemy CDN i sieci.
Typowe przyczyny wolnego TTFB
Twój HTML nie jest cachowany
To najczęstszy problem w witrynach treściowych i ecommerce. Zasoby statyczne są cachowane agresywnie, ale dokument HTML — rzecz, której przeglądarka potrzebuje jako pierwszej — jest generowany przy każdym żądaniu.
Czasem jest to konieczne. Często nie jest.
Jeśli publiczna strona zmienia się kilka razy dziennie, prawdopodobnie nie powinna wymagać świeżego renderowania z bazy danych dla każdego anonimowego odwiedzającego. W odpowiednich miejscach używaj cache całej strony, edge caching, generowania statycznego albo wzorców stale-while-revalidate.
Sprawdź nagłówki odpowiedzi pod kątem sygnałów takich jak Cache-Control, CDN-Cache-Status, Age, Vary i Set-Cookie. Strona, która wysyła unikalne ciasteczko każdemu odwiedzającemu, może przypadkowo sprawić, że sama stanie się niecacheowalna. Jeśli potrzebujesz praktycznego sposobu myślenia o tej warstwie, te same nawyki debugowania opisane w naszym przewodniku po przekierowaniach i nagłówkach HTTP na produkcji mają bezpośrednie zastosowanie przy pracy nad TTFB.
CDN cachuje tylko zasoby
Wiele zespołów dodaje CDN i zakłada, że praca nad wydajnością jest zakończona. Ale jeśli CDN serwuje tylko obrazy, CSS i JavaScript, pierwsze żądanie HTML nadal może podróżować aż do pojedynczego serwera origin.
Może to być w porządku dla lokalnej strony firmy z lokalnymi użytkownikami. Nie jest w porządku dla międzynarodowej publiczności. Im dalej użytkownik znajduje się od origin, tym większe opóźnienie płacisz, zanim praca backendu w ogóle się zacznie.
Dobra konfiguracja CDN pod TTFB zwykle oznacza:
- Cachowanie publicznego HTML tam, gdzie jest to bezpieczne
- Respektowanie celowych reguł pomijania cache dla stron uwierzytelnionych lub spersonalizowanych
- Unikanie niepotrzebnych nagłówków
Vary, które zbyt drobno dzielą cache - Używanie czyszczenia cache lub rewalidacji zamiast całkowitego wyłączania cache
- Potwierdzenie, że lokalizacje brzegowe rzeczywiście serwują trafienia, a nie przekazują każde żądanie dalej
CDN nie jest magią. To warstwa cache i routingu. Traktuj ją właśnie tak.
Serwer robi zbyt dużo przed odpowiedzią
Wolna ścieżka backendu może wynikać z wielu małych opóźnień: zapytań do bazy danych, wywołań API, renderowania szablonów, sprawdzania flag funkcji, uwierzytelniania, personalizacji, logowania i cold starts.
Najgorszym wzorcem jest praca z zależnościami wykonywana szeregowo. Na przykład:
- Pobierz dane strony
- Następnie pobierz powiązane produkty
- Następnie pobierz ceny
- Następnie wywołaj usługę rekomendacji
- Następnie wyrenderuj HTML
Jeśli każdy krok czeka na poprzedni, TTFB szybko rośnie. Zrównoleglaj niezależną pracę, usuń niekrytyczne wywołania z pierwszej odpowiedzi i cachuj kosztowne wyniki.
Przydatna zasada: jeśli użytkownik nie może od razu zobaczyć ani użyć wyniku, prawdopodobnie nie powinien on blokować pierwszego bajtu.
Zapytania do bazy danych są wolne lub nieprzewidywalne
Bazy danych często powodują problemy z TTFB, ponieważ dobrze zachowują się w development, a słabo pod prawdziwym ruchem. Brakujące indeksy, duże joiny, zapytania N+1, rywalizacja o blokady i zbyt duże zestawy wyników wszystkie objawiają się jako „serwer jest wolny”.
Tutaj nie zgaduj. Zbieraj czasy zapytań dla wolnych żądań. Patrz na p95 i p99, nie tylko na średnie. Strona, która zwykle odpowiada w 120 ms, ale czasem blokuje się na 4 sekundy, nadal tworzy złe doświadczenie użytkownika.
Typowe poprawki obejmują:
- Dodanie lub poprawienie indeksów
- Usunięcie wzorców zapytań N+1
- Cachowanie danych często odczytywanych
- Paginację dużych zapytań
- Przeniesienie zapytań raportowych lub analitycznych poza czas obsługi żądania
- Ustawienie rozsądnych timeoutów dla wywołań downstream
Aplikacja ma cold starts
Platformy serverless i kontenerowe mogą być świetne, ale cold starts mogą szkodzić TTFB, gdy ruch jest skokowy albo regiony są niedostatecznie zaopatrzone.
Jeśli pierwsze żądanie po okresie bezczynności jest dużo wolniejsze niż kolejne, zbadaj cold starts. Możesz potrzebować provisioned concurrency, mniejszych paczek, mniejszej liczby zależności startowych, podgrzewanych funkcji albo innego kształtu wdrożenia dla tras wrażliwych na opóźnienia.
To nie jest argument przeciwko serverless. To argument przeciwko udawaniu, że model runtime jest niewidoczny.
Przekierowania marnują pierwsze żądanie
Przekierowanie dodaje kolejny cykl żądanie-odpowiedź, zanim przeglądarka otrzyma finalny dokument. Jedno przekierowanie z http:// do https:// może być nieuniknione dla starych linków, ale łańcuchy są marnotrawstwem.
Typowe łańcuchy obejmują:
http://example.com→https://example.com→https://www.example.com- normalizację końcowego ukośnika po normalizacji protokołu
- przekierowania geograficzne lub językowe przed sprawdzeniem cache
- stare linki kampanijne, które przeskakują przez kilka URL-i
Naprawiaj linki u źródła tam, gdzie to możliwe, scalaj reguły przekierowań i ustawiaj kanoniczne URL-e jako bezpośrednie. Czas przekierowania nie zawsze jest raportowany jako TTFB końcowego żądania, ale użytkownik nadal za niego płaci.
Praktyczna kolejność debugowania
Gdy TTFB wygląda na wolny, użyj tej kolejności. Pomaga uniknąć częstego błędu optymalizowania kodu aplikacji, zanim potwierdzisz zachowanie cache i routingu.
Krok 1: Testuj główny dokument, nie tylko całą stronę
Znajdź żądanie dokumentu HTML. Zapisz całkowity TTFB i rozbicie czasów. Powtórz z cache przeglądarki i bez niego. Jeśli ma to znaczenie, przetestuj stronę publiczną, stronę dynamiczną i stronę po zalogowaniu.
Krok 2: Porównaj regiony
Uruchom ten sam URL z kilku lokalizacji geograficznych. Jeśli wolne regiony korelują z odległością od origin, priorytetem powinny być CDN i edge caching. Jeśli każdy region jest wolny, przyjrzyj się przetwarzaniu backendu i pojemności origin.
Krok 3: Sprawdź nagłówki odpowiedzi
Szukaj nagłówków cache, ciasteczek, Age, statusu CDN i Vary. Brakujący nagłówek Age albo powtarzające się chybienia cache to wskazówki. Szeroki nagłówek Vary: Cookie na publicznym HTML często zabija cache.
Krok 4: Sprawdź czasy origin
Dodaj instrumentację czasów serwera. Nagłówek Server-Timing może ujawnić fazy backendu, takie jak czas bazy danych, czas renderowania i czas upstream API. Nawet proste etykiety są użyteczne:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Teraz czasy w przeglądarce mogą pokazać, czy serwer spędził 300 ms na realnej pracy, czy opóźnienie wydarzyło się, zanim żądanie dotarło do aplikacji.
Krok 5: Napraw największe potwierdzone opóźnienie
Brzmi to oczywiście, ale zespoły często naprawiają to, co znają, zamiast tego, co zostało zmierzone. Jeśli dominują chybienia cache, napraw cache. Jeśli dominuje baza danych, napraw zapytania. Jeśli dla globalnych użytkowników dominują TLS i zestawianie połączenia, napraw routing, pokrycie CDN albo geografię origin.
Praca nad front-endem nadal ma znaczenie. Fonty, obrazy i JavaScript wpływają na to, co dzieje się po dotarciu HTML. Nie zastępują jednak szybkiej pierwszej odpowiedzi. Jeśli równolegle pracujesz nad wydajnością renderowania, fonty webowe wciąż należą do najłatwiejszych zwycięstw w wielu witrynach, ponieważ wpływają na to, jak szybko tekst staje się użyteczny po dotarciu dokumentu.
Poprawki, które zwykle działają
Cachuj publiczny HTML na krawędzi
Dla stron marketingowych, dokumentacji, blogów, landing page’y i stron kategorii edge caching często daje największą poprawę TTFB. Używaj krótkich TTL, jeśli treść często się zmienia. Używaj stale-while-revalidate, jeśli lekko nieświeża treść jest akceptowalna, podczas gdy cache odświeża się w tle.
Uważaj na personalizację. Jeśli strona różni się walutą, językiem, stanem zalogowania albo grupą eksperymentu, zdefiniuj te warianty jawnie. Przypadkowa zmienność per użytkownik niszczy efektywność cache.
Przenieś niekrytyczną pracę poza ścieżkę żądania
Wysyłanie emaili, wzbogacanie analityki, generowanie rekomendacji, wywołania webhooków i ciężkie logowanie rzadko powinny blokować pierwszy bajt. Umieść je w kolejkach albo uruchamiaj po rozpoczęciu odpowiedzi.
Ogranicz łańcuchy zależności backendu
Zrównoleglaj niezależne wywołania. Cachuj odpowiedzi z wolnych API. Ustawiaj timeouty. Projektuj treści zastępcze dla usług, które są pomocne, ale nie niezbędne.
Wolny widget rekomendacji nie powinien opóźniać całej strony produktu.
Umieść obliczenia bliżej użytkowników
Jeśli użytkownicy są globalni, a origin znajduje się w jednym regionie, opóźnienie ma charakter strukturalny. Cachowanie CDN może ukryć dużą część tego problemu dla treści publicznych. Dla treści dynamicznych rozważ wdrożenia regionalne, edge rendering dla odpowiednich tras albo przeniesienie API bliżej odbiorców.
Utrzymuj przekierowania nudne
Kanonizuj URL-e w jednym skoku. Aktualizuj linki wewnętrzne, aby użytkownicy i crawlery trafiali bezpośrednio do miejsca docelowego. Audytuj stare URL-e kampanii i migracje platform. Przekierowania łatwo ignorować, bo są niewidoczne, gdy działają, ale nadal kosztują czas.
Czego nie robić
Nie ścigaj idealnej wartości TTFB dla każdej trasy. Uwierzytelniony raport wykonujący realne obliczenia nie będzie zachowywał się jak cachowany wpis na blogu.
Nie używaj średniego TTFB jako jedynej metryki. Percentyle mają znaczenie. Geografia ma znaczenie. Typ strony ma znaczenie.
Nie zakładaj, że CDN oznacza, że HTML jest cachowany. Zweryfikuj to.
I nie traktuj TTFB jako czegoś oddzielnego od decyzji produktowych. Personalizacja, eksperymenty, stan magazynowy w czasie rzeczywistym i usługi zewnętrzne mają swoje koszty opóźnień. Niektóre są tego warte. Niektóre są tylko nawykiem.
<!-- tool-cta:start -->
💡 Wypróbuj to: Podczas diagnozowania TTFB Get Headers ujawnia stan pamięci podręcznej, czasy serwera i przekierowania, które często wyjaśniają, skąd pochodzi opóźnienie.
<!-- tool-cta:end -->
Spokojna wersja planu
Wolny TTFB zwykle da się naprawić, gdy przestaniesz traktować go jako niejasny „problem z serwerem”. Zmierz żądanie dokumentu. Segmentuj według regionu i typu strony. Sprawdź nagłówki. Porównaj czas klienta z czasem origin. Następnie napraw największe potwierdzone wąskie gardło.
Większość witryn nie potrzebuje egzotycznej architektury. Potrzebuje mniej możliwych do uniknięcia chybień cache, mniej blokującej pracy backendu, czystszych przekierowań i jaśniejszego pojęcia, co musi się wydarzyć przed wysłaniem pierwszego bajtu.
Najczęściej zadawane pytania
Czy TTFB jest metryką Core Web Vitals?
Jaki jest dobry cel TTFB?
Czy dodanie CDN automatycznie naprawi TTFB?
Czy optymalizacja JavaScript może poprawić TTFB?
Dlaczego TTFB jest wolny tylko dla zalogowanych użytkowników?
Źródła i dalsza lektura