Pourquoi votre Time to First Byte est lent et que faire pour y remédier
Le TTFB n’est pas un bogue unique. C’est le délai visible causé par le DNS, l’établissement de la connexion, le routage CDN, le travail serveur, les échecs de cache et, parfois, une seule requête de base de données lente.
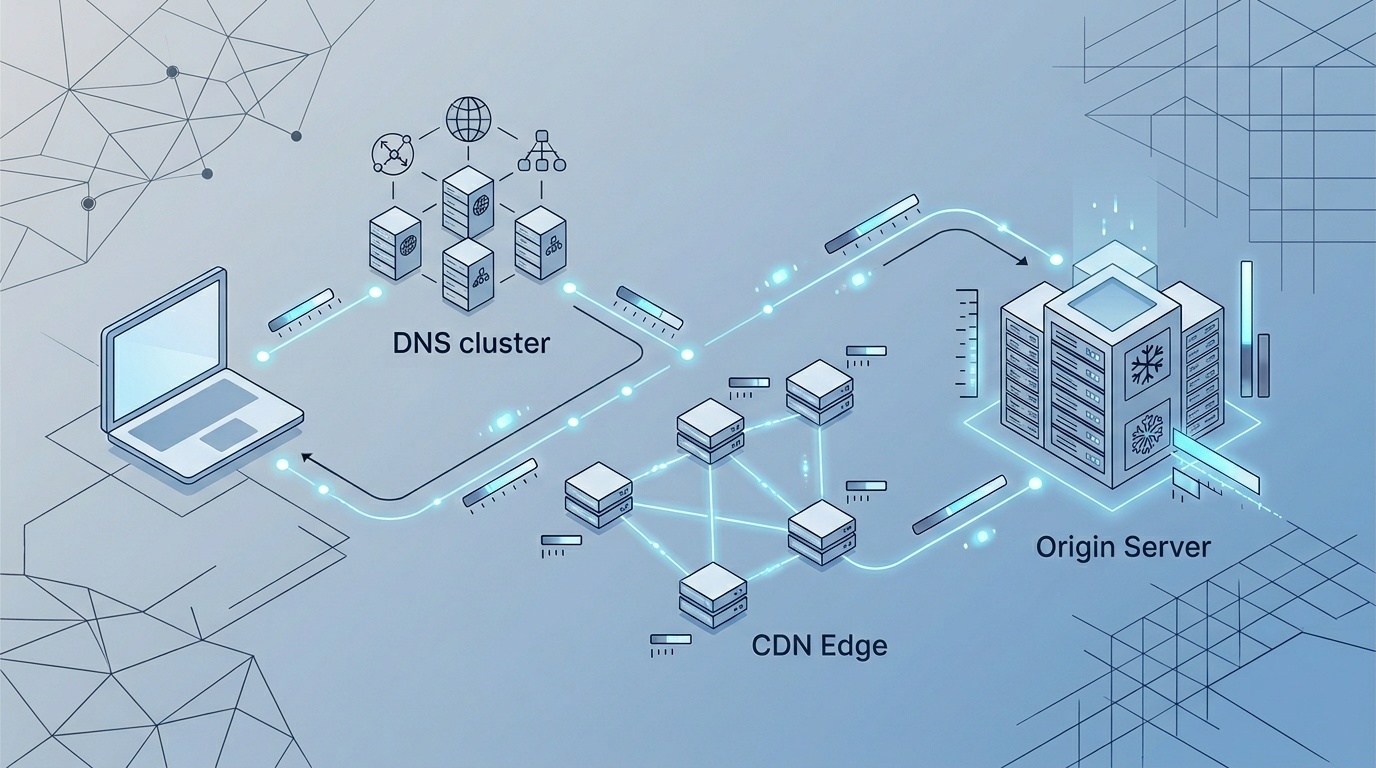
Table des matières
- Commencez par comprendre ce que mesure réellement le TTFB
- Qu’est-ce qu’un TTFB lent ?
- Mesurez-le à plusieurs endroits
- 1. Les outils de développement du navigateur
- 2. Des tests synthétiques depuis plusieurs régions
- 3. Le suivi des utilisateurs réels ou les journaux serveur
- Les causes habituelles d’un TTFB lent
- Votre HTML n’est pas mis en cache
- Votre CDN ne met en cache que les ressources
- Votre serveur en fait trop avant de répondre
- Les requêtes de base de données sont lentes ou imprévisibles
- Votre application a des cold starts
- Les redirections gaspillent la première requête
- Une séquence de débogage pratique
- Étape 1 : Testez le document principal, pas seulement la page entière
- Étape 2 : Comparez les régions
- Étape 3 : Inspectez les en-têtes de réponse
- Étape 4 : Vérifiez le timing de l’origine
- Étape 5 : Corrigez le plus grand délai confirmé
- Les corrections qui fonctionnent généralement
- Mettez en cache le HTML public en périphérie
- Déplacez le travail non critique hors du chemin de requête
- Réduisez les chaînes de dépendances backend
- Rapprochez le calcul des utilisateurs
- Gardez les redirections ennuyeuses
- Ce qu’il ne faut pas faire
- La version posée du plan
Commencez par comprendre ce que mesure réellement le TTFB
Time to First Byte, généralement abrégé en TTFB, est le temps qui s’écoule entre le moment où le navigateur demande une ressource et celui où il reçoit le premier octet de la réponse.
Cela ressemble à une métrique serveur, mais ce n’est pas seulement une métrique serveur. Le TTFB inclut plusieurs étapes :
- La résolution DNS, si le nom d’hôte n’est pas déjà résolu
- L’établissement de la connexion TCP
- La négociation TLS pour HTTPS
- Le temps de trajet de la requête jusqu’au serveur ou au point de présence CDN
- La mise en file d’attente et le traitement sur le serveur
- Le temps de trajet de la réponse jusqu’au navigateur
Un TTFB élevé peut donc signifier que votre backend est lent. Il peut aussi signifier que l’utilisateur est loin de votre origine, que votre CDN est mal configuré, que votre cache manque constamment ses cibles ou que votre serveur passe trop de temps à décider quoi envoyer.
C’est important parce que le TTFB se situe près du début de la chaîne de chargement. Si le document HTML arrive en retard, le navigateur découvre aussi tardivement le CSS, le JavaScript, les polices et les images. Vous pouvez avoir une excellente optimisation front-end et donner tout de même une impression de lenteur si la première réponse du document prend 1,5 seconde.
Qu’est-ce qu’un TTFB lent ?
Il n’existe pas de chiffre universel adapté à tous les sites, toutes les régions et toutes les architectures. Des seuils pratiques restent toutefois utiles.
Les recommandations de web.dev de Google classent un bon TTFB sous 800 ms, avec 800–1800 ms comme plage à améliorer, et plus de 1800 ms comme mauvais résultat. Pour une page marketing bien mise en cache et servie près de l’utilisateur, vous pouvez souvent faire beaucoup mieux. Pour un tableau de bord authentifié complexe qui effectue du travail dynamique, le chiffre acceptable peut être plus élevé, mais il doit tout de même pouvoir s’expliquer.
L’habitude importante consiste à segmenter le chiffre. Un TTFB moyen mondial de 900 ms peut masquer une réponse à 150 ms pour les utilisateurs proches de votre point de présence CDN et une réponse à 2200 ms pour les utilisateurs d’une autre région. De même, votre page d’accueil peut être correcte tandis que les pages de recherche, de catégorie ou connectées sont discrètement pénibles.
Mesurez-le à plusieurs endroits
Ne diagnostiquez pas le TTFB à partir d’une seule exécution de Lighthouse. Lighthouse est utile, mais il s’agit d’un test unique dans un environnement unique. Si vous débutez dans son interprétation, commencez par une lecture posée de la manière de lire un rapport Lighthouse sans paniquer — la leçon principale est de distinguer les signaux de laboratoire de la réalité terrain.
Pour le TTFB, vous devez avoir au moins trois vues :
1. Les outils de développement du navigateur
Ouvrez le panneau Network, rechargez avec le cache désactivé et inspectez la requête du document principal. La décomposition des timings montre les phases DNS, connexion, TLS, attente et téléchargement. La phase « waiting » correspond souvent à ce que les gens appellent le temps backend, même si elle peut inclure une latence en amont.
2. Des tests synthétiques depuis plusieurs régions
Lancez des tests depuis des emplacements proches et éloignés de vos utilisateurs. Si le TTFB est bas dans une région et élevé dans une autre, suspectez la géographie, le routage CDN, l’emplacement de l’origine ou la couverture du cache avant de réécrire le code applicatif.
3. Le suivi des utilisateurs réels ou les journaux serveur
Les données terrain vous indiquent ce que vivent de vrais utilisateurs sur différents appareils, réseaux et sessions. Les journaux serveur peuvent vous dire si l’origine a généré une réponse rapidement. La différence entre le TTFB observé côté client et le temps de traitement à l’origine est souvent l’endroit où apparaissent les problèmes de CDN et de réseau.
Les causes habituelles d’un TTFB lent
Votre HTML n’est pas mis en cache
C’est le problème le plus courant sur les sites de contenu et les sites ecommerce. Les ressources statiques sont mises en cache de manière agressive, mais le document HTML — ce dont le navigateur a besoin en premier — est généré à chaque requête.
Parfois, c’est nécessaire. Souvent, ça ne l’est pas.
Si une page publique change quelques fois par jour, elle ne devrait probablement pas nécessiter un rendu frais depuis la base de données pour chaque visiteur anonyme. Utilisez la mise en cache de page complète, la mise en cache en périphérie, la génération statique ou des modèles stale-while-revalidate lorsque c’est approprié.
Vérifiez les en-têtes de réponse à la recherche de signaux comme Cache-Control, CDN-Cache-Status, Age, Vary et Set-Cookie. Une page qui envoie un cookie unique à chaque visiteur peut se rendre accidentellement impossible à mettre en cache. Si vous avez besoin d’une méthode pratique pour raisonner sur cette couche, les mêmes habitudes de débogage décrites dans notre guide sur les redirections et les en-têtes HTTP en production s’appliquent directement au travail sur le TTFB.
Votre CDN ne met en cache que les ressources
Beaucoup d’équipes ajoutent un CDN et supposent que le travail de performance est terminé. Mais si le CDN ne sert que les images, le CSS et le JavaScript, la première requête HTML peut encore parcourir tout le chemin jusqu’à un serveur d’origine unique.
Cela peut convenir à un site d’entreprise locale avec des utilisateurs locaux. Ce n’est pas acceptable pour une audience internationale. Plus l’utilisateur est loin de l’origine, plus vous payez de latence avant même que le travail backend commence.
Une bonne configuration CDN pour le TTFB signifie généralement :
- Mettre en cache le HTML public lorsque c’est sûr
- Respecter les règles de contournement intentionnelles pour les pages authentifiées ou personnalisées
- Éviter les en-têtes
Varyinutiles qui fragmentent trop finement le cache - Utiliser la purge ou la revalidation du cache au lieu de désactiver entièrement le cache
- Confirmer que les emplacements périphériques servent réellement des hits, au lieu de transférer chaque requête
Un CDN n’est pas magique. C’est une couche de cache et de routage. Traitez-le comme tel.
Votre serveur en fait trop avant de répondre
Un chemin backend lent peut provenir de nombreux petits délais : requêtes de base de données, appels API, rendu de modèles, vérifications de feature flags, authentification, personnalisation, journalisation et cold starts.
Le pire schéma est le travail de dépendances en série. Par exemple :
- Récupérer les données de la page
- Puis récupérer les produits associés
- Puis récupérer les prix
- Puis appeler un service de recommandations
- Puis rendre le HTML
Si chaque étape attend la précédente, le TTFB augmente rapidement. Parallélisez le travail indépendant, retirez les appels non critiques de la première réponse et mettez en cache les résultats coûteux.
Une règle utile : si l’utilisateur ne peut pas voir ou utiliser le résultat immédiatement, il ne devrait probablement pas bloquer le premier octet.
Les requêtes de base de données sont lentes ou imprévisibles
Les bases de données provoquent souvent des problèmes de TTFB parce qu’elles se comportent bien en développement et mal sous trafic réel. Index manquants, jointures volumineuses, requêtes N+1, contention de verrous et ensembles de résultats surdimensionnés apparaissent tous comme « le serveur est lent ».
Ne devinez pas ici. Capturez les timings de requêtes pour les requêtes lentes. Regardez les p95 et p99, pas seulement les moyennes. Une page qui répond généralement en 120 ms mais bloque parfois pendant 4 secondes créera tout de même une mauvaise expérience utilisateur.
Les corrections courantes incluent :
- Ajouter ou corriger des index
- Supprimer les schémas de requêtes N+1
- Mettre en cache les données à forte lecture
- Paginer les grandes requêtes
- Déplacer les requêtes de reporting ou d’analytics hors du temps de requête
- Définir des délais d’expiration raisonnables pour les appels en aval
Votre application a des cold starts
Les plateformes serverless et conteneurisées peuvent être excellentes, mais les cold starts peuvent nuire au TTFB lorsque le trafic est en rafales ou que les régions sont sous-provisionnées.
Si votre première requête après une période d’inactivité est beaucoup plus lente que les suivantes, enquêtez sur les cold starts. Vous pourriez avoir besoin de concurrence provisionnée, de bundles plus petits, de moins de dépendances au démarrage, de fonctions réchauffées ou d’une forme de déploiement différente pour les routes sensibles à la latence.
Ce n’est pas un argument contre le serverless. C’est un argument contre l’idée que le modèle d’exécution serait invisible.
Les redirections gaspillent la première requête
Une redirection ajoute un autre cycle requête-réponse avant que le navigateur reçoive le document final. Une redirection de http:// vers https:// peut être inévitable pour les anciens liens, mais les chaînes sont coûteuses.
Les chaînes courantes incluent :
http://example.com→https://example.com→https://www.example.com- la normalisation de la barre oblique finale après la normalisation du protocole
- les redirections géographiques ou linguistiques avant la recherche dans le cache
- les anciens liens de campagne qui passent par plusieurs URLs
Corrigez les liens à la source lorsque c’est possible, regroupez les règles de redirection et rendez les URLs canoniques directes. Le temps de redirection n’est pas toujours signalé comme TTFB pour la requête finale, mais l’utilisateur le paie quand même.
Une séquence de débogage pratique
Quand le TTFB semble lent, suivez cet ordre. Il évite l’erreur courante qui consiste à optimiser le code applicatif avant de confirmer le comportement du cache et du routage.
Étape 1 : Testez le document principal, pas seulement la page entière
Trouvez la requête du document HTML. Notez le TTFB total et la décomposition des timings. Répétez avec et sans cache navigateur. Testez une page publique, une page dynamique et une page connectée si c’est pertinent.
Étape 2 : Comparez les régions
Exécutez la même URL depuis plusieurs emplacements géographiques. Si les régions lentes corrèlent avec la distance à l’origine, priorisez le CDN et la mise en cache en périphérie. Si toutes les régions sont lentes, examinez le traitement backend et la capacité de l’origine.
Étape 3 : Inspectez les en-têtes de réponse
Cherchez les en-têtes de cache, les cookies, Age, le statut CDN et Vary. Un en-tête Age manquant ou des échecs de cache répétés sont des indices. Un en-tête large Vary: Cookie sur du HTML public est souvent un destructeur de cache.
Étape 4 : Vérifiez le timing de l’origine
Ajoutez une instrumentation de timing serveur. L’en-tête Server-Timing peut exposer des phases backend comme le temps de base de données, le temps de rendu et le temps d’API en amont. Même des libellés simples sont utiles :
Server-Timing: db;dur=82, render;dur=41, api;dur=210Vos timings navigateur peuvent maintenant montrer si le serveur a passé 300 ms sur du vrai travail ou si le délai s’est produit avant que la requête atteigne votre application.
Étape 5 : Corrigez le plus grand délai confirmé
Cela paraît évident, mais les équipes corrigent souvent ce qui leur est familier plutôt que ce qui est mesuré. Si les échecs de cache dominent, corrigez la mise en cache. Si la base de données domine, corrigez les requêtes. Si TLS et l’établissement de connexion dominent pour les utilisateurs mondiaux, corrigez le routage, la couverture CDN ou la géographie de l’origine.
Le travail front-end compte toujours. Les polices, les images et le JavaScript influencent ce qui se passe après l’arrivée du HTML. Mais ils ne remplacent pas une première réponse rapide. Si vous travaillez aussi sur la performance de rendu, les polices web restent l’un des gains les plus faciles sur de nombreux sites, car elles influencent la vitesse à laquelle le texte devient utilisable après l’arrivée du document.
Les corrections qui fonctionnent généralement
Mettez en cache le HTML public en périphérie
Pour les pages marketing, la documentation, les blogs, les pages d’atterrissage et les pages de catégorie, la mise en cache en périphérie est souvent la plus grande amélioration du TTFB. Utilisez des TTL courts si le contenu change fréquemment. Utilisez stale-while-revalidate si un contenu légèrement périmé est acceptable pendant que le cache se rafraîchit en arrière-plan.
Soyez prudent avec la personnalisation. Si une page varie selon la devise, la langue, l’état de connexion ou le groupe d’expérimentation, définissez ces variantes explicitement. Une variation accidentelle par utilisateur détruit l’efficacité du cache.
Déplacez le travail non critique hors du chemin de requête
L’envoi d’e-mails, l’enrichissement analytics, la génération de recommandations, les appels webhook et la journalisation lourde devraient rarement bloquer le premier octet. Placez-les dans des files d’attente ou exécutez-les après le début de la réponse.
Réduisez les chaînes de dépendances backend
Parallélisez les appels indépendants. Mettez en cache les réponses des APIs lentes. Définissez des délais d’expiration. Concevez du contenu de repli pour les services utiles mais non essentiels.
Un widget de recommandations lent ne devrait pas retarder toute la page produit.
Rapprochez le calcul des utilisateurs
Si vos utilisateurs sont mondiaux et que votre origine se trouve dans une seule région, la latence est structurelle. La mise en cache CDN peut en masquer une grande partie pour le contenu public. Pour le contenu dynamique, envisagez des déploiements régionaux, un rendu en périphérie pour les routes appropriées ou le déplacement des APIs plus près de l’audience.
Gardez les redirections ennuyeuses
Canonicalisez les URLs en un seul saut. Mettez à jour les liens internes afin que les utilisateurs et les robots accèdent directement à la destination finale. Auditez les anciennes URLs de campagne et les migrations de plateforme. Les redirections sont faciles à ignorer parce qu’elles sont invisibles lorsqu’elles fonctionnent, mais elles coûtent tout de même du temps.
Ce qu’il ne faut pas faire
Ne poursuivez pas un TTFB parfait pour chaque route. Un rapport authentifié qui effectue un vrai calcul ne se comportera pas comme un article de blog mis en cache.
N’utilisez pas le TTFB moyen comme seule métrique. Les percentiles comptent. La géographie compte. Le type de page compte.
Ne supposez pas qu’un CDN signifie que votre HTML est mis en cache. Vérifiez-le.
Et ne traitez pas le TTFB comme séparé des décisions produit. La personnalisation, l’expérimentation, l’inventaire en temps réel et les services tiers ont tous des coûts de latence. Certains en valent la peine. D’autres ne sont que des habitudes.
<!-- tool-cta:start -->
💡 Essayez ceci: Lors du diagnostic du TTFB, Get Headers révèle l’état du cache, les temps serveur et les redirections qui expliquent souvent d’où vient le délai.
<!-- tool-cta:end -->
La version posée du plan
Un TTFB lent est généralement corrigeable dès que vous cessez de le traiter comme un vague « problème serveur ». Mesurez la requête du document. Segmentez par région et par type de page. Inspectez les en-têtes. Comparez le timing client au timing d’origine. Corrigez ensuite le plus grand goulot d’étranglement confirmé.
La plupart des sites n’ont pas besoin d’une architecture exotique. Ils ont besoin de moins d’échecs de cache évitables, de moins de travail backend bloquant, de redirections plus propres et d’une idée plus claire de ce qui doit se produire avant l’envoi du premier octet.
Questions fréquemment posées
Le TTFB est-il une métrique Core Web Vitals ?
Quelle est une bonne cible de TTFB ?
Ajouter un CDN corrigera-t-il automatiquement le TTFB ?
L’optimisation JavaScript peut-elle améliorer le TTFB ?
Pourquoi mon TTFB est-il lent seulement pour les utilisateurs connectés ?
Sources et lectures complémentaires