Waarom je Time to First Byte traag is en wat je eraan kunt doen
TTFB is geen afzonderlijke bug. Het is de zichtbare vertraging die wordt veroorzaakt door DNS, verbindingsopbouw, CDN-routering, serverwerk, cache-misses en soms één trage databasequery.
Inhoudsopgave
- Begin met wat TTFB echt meet
- Wat telt als een trage TTFB?
- Meet het op meer dan één plek
- 1. Browser developer tools
- 2. Synthetische tests vanuit meerdere regio’s
- 3. Real user monitoring of serverlogs
- De gebruikelijke oorzaken van trage TTFB
- Je HTML wordt niet gecachet
- Je CDN cachet alleen assets
- Je server doet te veel voordat hij reageert
- Databasequeries zijn traag of onvoorspelbaar
- Je applicatie heeft cold starts
- Redirects verspillen de eerste request
- Een praktische debugvolgorde
- Step 1: Test het hoofddocument, niet alleen de hele pagina
- Step 2: Vergelijk regio’s
- Step 3: Inspecteer responseheaders
- Step 4: Controleer origin-timing
- Step 5: Los de grootste bevestigde vertraging op
- Oplossingen die meestal werken
- Cache openbare HTML aan de edge
- Haal niet-kritiek werk uit het requestpad
- Verminder backend-afhankelijkheidsketens
- Zet compute dichter bij gebruikers
- Houd redirects saai
- Wat je niet moet doen
- De rustige versie van het plan
Begin met wat TTFB echt meet
Time to First Byte, meestal afgekort tot TTFB, is de tijd tussen het moment waarop de browser een resource aanvraagt en het moment waarop de eerste byte van de respons binnenkomt.
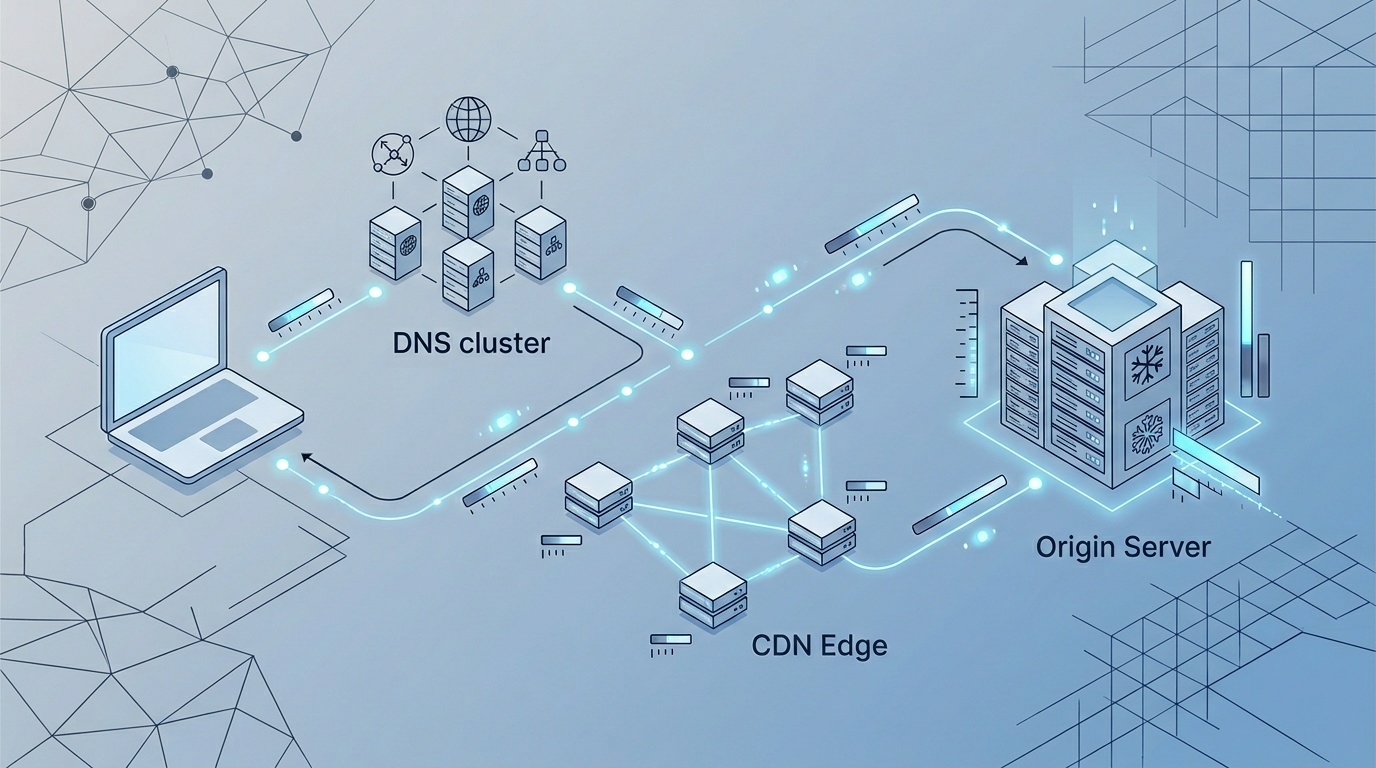
Dat klinkt als een servermetric, maar het is niet alleen een servermetric. TTFB omvat meerdere stappen:
- DNS-lookup, als de hostnaam nog niet is opgelost
- TCP-verbindingsopbouw
- TLS-onderhandeling voor HTTPS
- Reistijd van de request naar de server of CDN-edge
- Wachtrijvorming en verwerking op de server
- Reistijd van de respons terug naar de browser
Een hoge TTFB kan dus betekenen dat je backend traag is. Het kan ook betekenen dat de gebruiker ver van je origin zit, dat je CDN verkeerd is geconfigureerd, dat je cache voortdurend mist, of dat je server te lang bezig is met bepalen wat hij moet terugsturen.
Dit is belangrijk omdat TTFB aan het begin van de laadketen zit. Als het HTML-document laat aankomt, ontdekt de browser CSS, JavaScript, fonts en afbeeldingen ook laat. Je kunt uitstekende front-endoptimalisatie hebben en toch traag aanvoelen als de eerste documentrespons 1,5 seconde duurt.
Wat telt als een trage TTFB?
Er is geen universeel getal dat past bij elke site, regio en architectuur. Toch helpen praktische drempels.
De richtlijnen van Google’s web.dev classificeren een goede TTFB als minder dan 800 ms, waarbij 800–1800 ms verbetering nodig heeft en meer dan 1800 ms als slecht wordt beschouwd. Voor een goed gecachete marketingpagina die dicht bij de gebruiker wordt geserveerd, kun je vaak veel beter presteren. Voor een complex geauthenticeerd dashboard dat dynamisch werk doet, kan een hoger getal acceptabel zijn, maar het moet nog steeds verklaarbaar zijn.
De belangrijke gewoonte is om het getal te segmenteren. Een wereldwijde gemiddelde TTFB van 900 ms kan een respons van 150 ms verbergen voor gebruikers dicht bij je CDN-edge en een respons van 2200 ms voor gebruikers in een andere regio. Op dezelfde manier kan je homepage prima zijn terwijl zoek-, categorie- of ingelogde pagina’s stilletjes pijnlijk traag zijn.
Meet het op meer dan één plek
Diagnosticeer TTFB niet op basis van één Lighthouse-run. Lighthouse is nuttig, maar het is één test vanuit één omgeving. Als je nog nieuw bent in het interpreteren ervan, begin dan met een rustige lezing van hoe je een Lighthouse-rapport leest zonder in paniek te raken — de belangrijkste les is om labsignalen te scheiden van de werkelijkheid in het veld.
Voor TTFB wil je minstens drie perspectieven:
1. Browser developer tools
Open het Network-paneel, herlaad met uitgeschakelde cache en inspecteer de request voor het hoofddocument. De timing-uitsplitsing toont DNS-, verbindings-, TLS-, wacht- en downloadfasen. De “waiting”-fase is vaak wat mensen bedoelen met backendtijd, al kan die ook upstream-latency bevatten.
2. Synthetische tests vanuit meerdere regio’s
Voer tests uit vanaf locaties dichtbij en ver weg van je gebruikers. Als TTFB in de ene regio laag is en in een andere hoog, denk dan eerst aan geografie, CDN-routering, origin-plaatsing of cachedekking voordat je applicatiecode herschrijft.
3. Real user monitoring of serverlogs
Velddata vertelt je wat echte gebruikers ervaren over apparaten, netwerken en sessies heen. Serverlogs kunnen je vertellen of de origin snel een respons heeft gegenereerd. Het verschil tussen door de client waargenomen TTFB en origin-verwerkingstijd is vaak waar CDN- en netwerkproblemen zichtbaar worden.
De gebruikelijke oorzaken van trage TTFB
Je HTML wordt niet gecachet
Dit is het meest voorkomende probleem op contentsites en e-commercesites. Statische assets worden agressief gecachet, maar het HTML-document — het ding dat de browser als eerste nodig heeft — wordt bij elke request opnieuw gegenereerd.
Soms is dat nodig. Vaak niet.
Als een openbare pagina een paar keer per dag verandert, zou die waarschijnlijk geen verse databaserender nodig moeten hebben voor elke anonieme bezoeker. Gebruik full-page caching, edge caching, statische generatie of stale-while-revalidate-patronen waar dat passend is.
Controleer responseheaders op signalen zoals Cache-Control, CDN-Cache-Status, Age, Vary en Set-Cookie. Een pagina die elke bezoeker een unieke cookie stuurt, kan zichzelf per ongeluk oncachebaar maken. Als je een praktische manier nodig hebt om over deze laag na te denken, zijn dezelfde debuggewoonten uit onze gids voor redirects en HTTP-headers in productie direct toepasbaar op TTFB-werk.
Je CDN cachet alleen assets
Veel teams voegen een CDN toe en nemen aan dat het prestatiewerk klaar is. Maar als het CDN alleen afbeeldingen, CSS en JavaScript serveert, kan de eerste HTML-request nog steeds helemaal naar één origin-server reizen.
Dat kan prima zijn voor een lokale bedrijfssite met lokale gebruikers. Het is niet prima voor een internationaal publiek. Hoe verder de gebruiker van de origin zit, hoe meer latency je betaalt voordat backendwerk überhaupt begint.
Goede CDN-configuratie voor TTFB betekent meestal:
- Cache openbare HTML waar dat veilig kan
- Respecteer bewuste bypass-regels voor geauthenticeerde of gepersonaliseerde pagina’s
- Vermijd onnodige
Vary-headers die de cache te fijn opsplitsen - Gebruik cache purging of revalidatie in plaats van cache volledig uit te schakelen
- Bevestig dat edge-locaties daadwerkelijk hits serveren en niet elke request doorsturen
Een CDN is geen magie. Het is een cache- en routeringslaag. Behandel het ook zo.
Je server doet te veel voordat hij reageert
Een traag backendpad kan ontstaan door veel kleine vertragingen: databasequeries, API-calls, templaterendering, featureflagcontroles, authenticatie, personalisatie, logging en cold starts.
Het slechtste patroon is serieel afhankelijkheidswerk. Bijvoorbeeld:
- Paginadata ophalen
- Daarna gerelateerde producten ophalen
- Daarna prijzen ophalen
- Daarna een recommendations-service aanroepen
- Daarna HTML renderen
Als elke stap wacht op de vorige, groeit TTFB snel. Paralleliseer onafhankelijk werk, haal niet-kritieke calls uit de eerste respons en cache dure resultaten.
Een nuttige vuistregel: als de gebruiker het resultaat niet direct kan zien of gebruiken, zou het waarschijnlijk de eerste byte niet moeten blokkeren.
Databasequeries zijn traag of onvoorspelbaar
Databases veroorzaken vaak TTFB-problemen omdat ze zich goed gedragen in development en slecht onder echt verkeer. Ontbrekende indexen, grote joins, N+1-queries, lock contention en te grote resultsets verschijnen allemaal als “de server is traag”.
Ga hier niet gokken. Leg querytimings vast voor trage requests. Kijk naar p95 en p99, niet alleen naar gemiddelden. Eén pagina die meestal in 120 ms reageert maar af en toe 4 seconden blokkeert, zorgt nog steeds voor een slechte gebruikerservaring.
Veelvoorkomende oplossingen zijn:
- Indexen toevoegen of corrigeren
- N+1-querypatronen verwijderen
- Read-heavy data cachen
- Grote queries pagineren
- Reporting- of analyticsqueries weghalen uit requesttijd
- Zinvolle timeouts instellen voor downstream-calls
Je applicatie heeft cold starts
Serverless en containerplatforms kunnen uitstekend zijn, maar cold starts kunnen TTFB schaden wanneer verkeer piekerig is of regio’s ondergedimensioneerd zijn.
Als je eerste request na inactiviteit veel trager is dan latere requests, onderzoek dan cold starts. Mogelijk heb je provisioned concurrency, kleinere bundles, minder start-up dependencies, warmere functies of een andere deploymentvorm nodig voor latencygevoelige routes.
Dit is geen argument tegen serverless. Het is een argument tegen doen alsof het runtimemodel onzichtbaar is.
Redirects verspillen de eerste request
Een redirect voegt nog een request-responsecyclus toe voordat de browser het uiteindelijke document ontvangt. Eén redirect van http:// naar https:// kan onvermijdelijk zijn voor oude links, maar ketens zijn verspilling.
Veelvoorkomende ketens zijn:
http://example.com→https://example.com→https://www.example.com- normalisatie van trailing slash na protocolnormalisatie
- geo- of taalredirects vóór cache lookup
- oude campagnelinks die via meerdere URL’s springen
Los bronlinks op waar mogelijk, voeg redirectregels samen en maak canonieke URL’s direct. Redirecttijd wordt niet altijd gerapporteerd als TTFB voor de uiteindelijke request, maar de gebruiker betaalt er nog steeds voor.
Een praktische debugvolgorde
Wanneer TTFB traag lijkt, gebruik dan deze volgorde. Zo voorkom je de veelgemaakte fout om applicatiecode te optimaliseren voordat cache- en routeringsgedrag is bevestigd.
Step 1: Test het hoofddocument, niet alleen de hele pagina
Vind de request voor het HTML-document. Noteer de totale TTFB en de timing-uitsplitsing. Herhaal met en zonder browsercache. Test een openbare pagina, een dynamische pagina en een ingelogde pagina als dat relevant is.
Step 2: Vergelijk regio’s
Voer dezelfde URL uit vanaf meerdere geografische locaties. Als de trage regio’s correleren met afstand tot de origin, geef dan prioriteit aan CDN en edge caching. Als elke regio traag is, kijk dan naar backendverwerking en origin-capaciteit.
Step 3: Inspecteer responseheaders
Zoek naar cacheheaders, cookies, Age, CDN-status en Vary. Een ontbrekende Age-header of herhaalde cache-misses zijn aanwijzingen. Een brede Vary: Cookie-header op openbare HTML is vaak een cachekiller.
Step 4: Controleer origin-timing
Voeg server timing-instrumentatie toe. De Server-Timing-header kan backendfasen blootleggen, zoals databasetijd, rendertijd en upstream API-tijd. Zelfs eenvoudige labels zijn nuttig:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Nu kunnen je browsertimings laten zien of de server 300 ms aan echt werk besteedde of dat de vertraging plaatsvond voordat de request je applicatie bereikte.
Step 5: Los de grootste bevestigde vertraging op
Dit klinkt vanzelfsprekend, maar teams lossen vaak op wat vertrouwd is in plaats van wat gemeten is. Als cache-misses domineren, los caching op. Als de database domineert, los queries op. Als TLS en verbindingsopbouw domineren voor wereldwijde gebruikers, los routering, CDN-dekking of origin-geografie op.
Front-endwerk blijft belangrijk. Fonts, afbeeldingen en JavaScript beïnvloeden wat er gebeurt nadat de HTML aankomt. Maar ze zijn geen vervanging voor een snelle eerste respons. Als je ook aan renderprestaties werkt, blijven webfonts een van de makkelijkste winstpunten op veel sites omdat ze beïnvloeden hoe snel tekst bruikbaar wordt nadat het document is aangekomen.
Oplossingen die meestal werken
Cache openbare HTML aan de edge
Voor marketingpagina’s, documentatie, blogs, landingspagina’s en categoriepagina’s is edge caching vaak de grootste TTFB-verbetering. Gebruik korte TTL’s als content vaak verandert. Gebruik stale-while-revalidate als licht verouderde content acceptabel is terwijl de cache op de achtergrond wordt ververst.
Wees voorzichtig met personalisatie. Als een pagina varieert per valuta, taal, loginstatus of experimentgroep, definieer die varianten dan expliciet. Onbedoelde variatie per gebruiker vernietigt cache-efficiëntie.
Haal niet-kritiek werk uit het requestpad
E-mails versturen, analyticsverrijking, recommendation-generatie, webhook-calls en zware logging zouden zelden de eerste byte moeten blokkeren. Zet ze in queues of voer ze uit nadat de respons is gestart.
Verminder backend-afhankelijkheidsketens
Paralleliseer onafhankelijke calls. Cache responses van trage API’s. Stel timeouts in. Ontwerp fallback-content voor services die nuttig zijn maar niet essentieel.
Een trage recommendations-widget zou niet de hele productpagina moeten vertragen.
Zet compute dichter bij gebruikers
Als je gebruikers wereldwijd zijn en je origin in één regio staat, is latency structureel. CDN-caching kan dit voor openbare content grotendeels verbergen. Overweeg voor dynamische content regionale deployments, edge rendering voor geschikte routes of API’s dichter bij het publiek te plaatsen.
Houd redirects saai
Canonicaliseer URL’s in één hop. Werk interne links bij zodat gebruikers en crawlers direct naar de eindbestemming gaan. Audit oude campagne-URL’s en platformmigraties. Redirects zijn makkelijk te negeren omdat ze onzichtbaar zijn wanneer ze werken, maar ze kosten nog steeds tijd.
Wat je niet moet doen
Jaag niet op een perfecte TTFB-score voor elke route. Een geauthenticeerd rapport dat echte berekeningen uitvoert, gedraagt zich niet als een gecachte blogpost.
Gebruik gemiddelde TTFB niet als je enige metric. Percentielen doen ertoe. Geografie doet ertoe. Paginatype doet ertoe.
Neem niet aan dat een CDN betekent dat je HTML wordt gecachet. Verifieer het.
En behandel TTFB niet als iets dat losstaat van productbeslissingen. Personalisatie, experimenten, realtime voorraad en third-party services hebben allemaal latencykosten. Sommige zijn het waard. Sommige zijn gewoon gewoonte.
<!-- tool-cta:start -->
💡 Probeer dit: Bij het diagnosticeren van TTFB onthult Get Headers de cachestatus, servertimings en omleidingen die vaak verklaren waar de vertraging vandaan komt.
<!-- tool-cta:end -->
De rustige versie van het plan
Een trage TTFB is meestal op te lossen zodra je stopt met het behandelen ervan als een vaag “serverprobleem”. Meet de documentrequest. Segmenteer op regio en paginatype. Inspecteer headers. Vergelijk client-timing met origin-timing. Los daarna de grootste bevestigde bottleneck op.
De meeste sites hebben geen exotische architectuur nodig. Ze hebben minder vermijdbare cache-misses nodig, minder blokkerend backendwerk, schonere redirects en een duidelijker idee van wat er moet gebeuren voordat de eerste byte wordt verzonden.
Veelgestelde vragen
Is TTFB een Core Web Vitals-metric?
Wat is een goed TTFB-doel?
Lost het toevoegen van een CDN TTFB automatisch op?
Kan JavaScript-optimalisatie TTFB verbeteren?
Waarom is mijn TTFB alleen traag voor ingelogde gebruikers?
Bronnen & verder lezen