Hvorfor din Time to First Byte er langsom, og hvad du kan gøre ved det
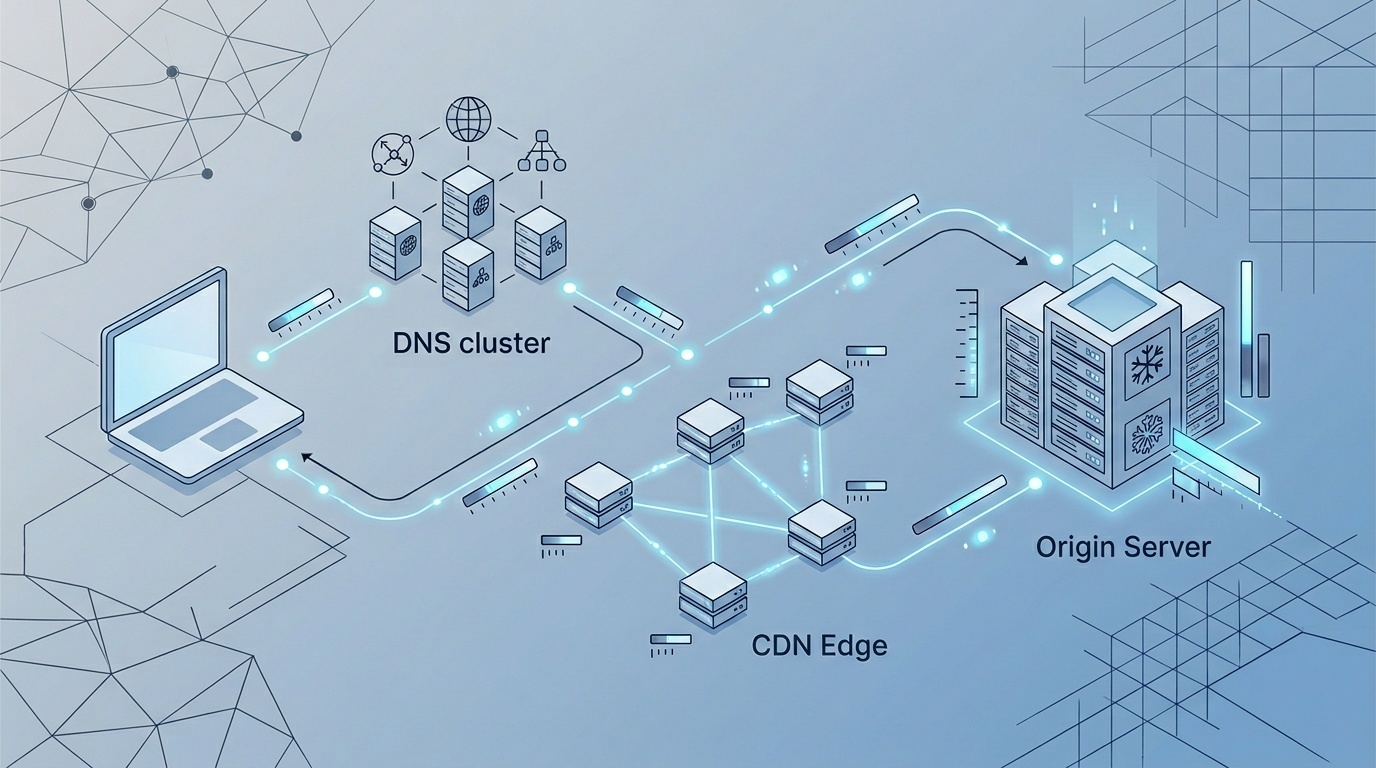
TTFB er ikke én enkelt fejl. Det er den synlige forsinkelse, der skyldes DNS, forbindelsesopsætning, CDN-routing, serverarbejde, cache-misses og nogle gange én langsom databaseforespørgsel.
Indholdsfortegnelse
- Start med, hvad TTFB faktisk måler
- Hvad tæller som en langsom TTFB?
- Mål det mere end ét sted
- 1. Browserens udviklerværktøjer
- 2. Syntetiske tests fra flere regioner
- 3. Real user monitoring eller serverlogs
- De sædvanlige årsager til langsom TTFB
- Din HTML bliver ikke cachet
- Dit CDN cacher kun assets
- Din server gør for meget, før den svarer
- Databaseforespørgsler er langsomme eller uforudsigelige
- Din applikation har cold starts
- Redirects spilder den første anmodning
- En praktisk debugging-sekvens
- Step 1: Test hoveddokumentet, ikke kun hele siden
- Step 2: Sammenlign regioner
- Step 3: Inspicér svarheadere
- Step 4: Tjek origin-timing
- Step 5: Ret den største bekræftede forsinkelse
- Løsninger, der som regel virker
- Cache offentlig HTML ved edge
- Flyt ikke-kritisk arbejde ud af request path
- Reducér backend-afhængighedskæder
- Placer compute tættere på brugerne
- Hold redirects kedelige
- Hvad du ikke skal gøre
- Den rolige version af planen
Start med, hvad TTFB faktisk måler
Time to First Byte, som normalt forkortes til TTFB, er tiden mellem, at browseren anmoder om en ressource, og at den modtager den første byte af svaret.
Det lyder som en servermåling, men det er ikke kun en servermåling. TTFB omfatter flere trin:
- DNS-opslag, hvis værtsnavnet ikke allerede er opløst
- Opsætning af TCP-forbindelse
- TLS-forhandling for HTTPS
- Anmodningens rejsetid til serveren eller CDN-edge
- Kø og behandling på serveren
- Svarets rejsetid tilbage til browseren
Så en høj TTFB kan betyde, at din backend er langsom. Det kan også betyde, at brugeren er langt fra din origin, at dit CDN er forkert konfigureret, at din cache konstant misser, eller at din server bruger for lang tid på at beslutte, hvad den skal sende.
Det betyder noget, fordi TTFB ligger tæt på begyndelsen af indlæsningskæden. Hvis HTML-dokumentet ankommer sent, opdager browseren også CSS, JavaScript, skrifttyper og billeder sent. Du kan have fremragende front-end-optimering og stadig føles langsom, hvis det første dokumentsvar tager 1,5 sekunder.
Hvad tæller som en langsom TTFB?
Der findes ikke ét universelt tal, der passer til alle sites, regioner og arkitekturer. Alligevel hjælper praktiske tærskler.
Googles web.dev-vejledning klassificerer en god TTFB som under 800 ms, hvor 800–1800 ms kræver forbedring, og over 1800 ms betragtes som dårligt. For en velcachet marketingside, der leveres tæt på brugeren, kan du ofte gøre det meget bedre end det. For et komplekst autentificeret dashboard, der udfører dynamisk arbejde, kan det acceptable tal være højere, men det bør stadig kunne forklares.
Den vigtige vane er at segmentere tallet. En global gennemsnitlig TTFB på 900 ms kan skjule et svar på 150 ms for brugere tæt på din CDN-edge og et svar på 2200 ms for brugere i en anden region. På samme måde kan din forside være fin, mens søge-, kategori- eller loggede sider stille og roligt er smertefulde.
Mål det mere end ét sted
Diagnosticér ikke TTFB ud fra en enkelt Lighthouse-kørsel. Lighthouse er nyttigt, men det er én test fra ét miljø. Hvis du er ny i at fortolke det, så start med en rolig læsning af, hvordan man læser en Lighthouse-rapport uden panik — hovedpointen er at adskille labsignaler fra virkeligheden i felten.
For TTFB bør du mindst have tre vinkler:
1. Browserens udviklerværktøjer
Åbn Network-panelet, genindlæs med cache deaktiveret, og inspicér anmodningen om hoveddokumentet. Timing-opdelingen viser DNS-, forbindelse-, TLS-, vente- og downloadfaser. “Vente”-fasen er ofte det, folk mener med backend-tid, selvom den kan omfatte upstream-latens.
2. Syntetiske tests fra flere regioner
Kør tests fra placeringer tæt på og langt fra dine brugere. Hvis TTFB er lav i én region og høj i en anden, bør du mistænke geografi, CDN-routing, origin-placering eller cachedækning, før du omskriver applikationskode.
3. Real user monitoring eller serverlogs
Feltdata fortæller dig, hvad rigtige brugere oplever på tværs af enheder, netværk og sessioner. Serverlogs kan fortælle dig, om origin genererede et svar hurtigt. Forskellen mellem klientobserveret TTFB og origin-behandlingstid er ofte der, CDN- og netværksproblemer viser sig.
De sædvanlige årsager til langsom TTFB
Din HTML bliver ikke cachet
Dette er det mest almindelige problem på indholdssites og e-handelswebsites. Statiske assets caches aggressivt, men HTML-dokumentet — det, browseren skal bruge først — genereres ved hver anmodning.
Nogle gange er det nødvendigt. Ofte er det ikke.
Hvis en offentlig side ændrer sig nogle få gange om dagen, bør den sandsynligvis ikke kræve en frisk database-rendering for hver anonym besøgende. Brug full-page caching, edge caching, statisk generering eller stale-while-revalidate-mønstre, hvor det er passende.
Tjek svarheadere for signaler som Cache-Control, CDN-Cache-Status, Age, Vary og Set-Cookie. En side, der sender en unik cookie til hver besøgende, kan ved et uheld gøre sig selv umulig at cache. Hvis du har brug for en praktisk måde at tænke over dette lag på, gælder de samme debugging-vaner i vores guide til redirects og HTTP-headere i produktion direkte for TTFB-arbejde.
Dit CDN cacher kun assets
Mange teams tilføjer et CDN og antager, at performance-arbejdet er gjort. Men hvis CDN'et kun leverer billeder, CSS og JavaScript, kan den første HTML-anmodning stadig rejse hele vejen til en enkelt origin-server.
Det kan være fint for et lokalt virksomhedswebsite med lokale brugere. Det er ikke fint for et internationalt publikum. Jo længere brugeren er fra origin, desto mere latens betaler du, før backend-arbejdet overhovedet starter.
God CDN-konfiguration for TTFB betyder som regel:
- Cache offentlig HTML, hvor det er sikkert
- Respektér tilsigtede bypass-regler for autentificerede eller personaliserede sider
- Undgå unødvendige
Vary-headere, der opdeler cachen for fint - Brug cache purging eller revalidering i stedet for at deaktivere cache helt
- Bekræft, at edge-placeringer faktisk leverer hits og ikke videresender hver anmodning
Et CDN er ikke magi. Det er et cache- og routinglag. Behandl det som et.
Din server gør for meget, før den svarer
En langsom backend-sti kan skyldes mange små forsinkelser: databaseforespørgsler, API-kald, template-rendering, feature flag-tjek, autentificering, personalisering, logging og cold starts.
Det værste mønster er serielt afhængighedsarbejde. For eksempel:
- Hent sidedata
- Hent derefter relaterede produkter
- Hent derefter priser
- Kald derefter en anbefalingstjeneste
- Render derefter HTML
Hvis hvert trin venter på det forrige, vokser TTFB hurtigt. Parallelisér uafhængigt arbejde, fjern ikke-kritiske kald fra det første svar, og cache dyre resultater.
En nyttig regel: Hvis brugeren ikke kan se eller bruge resultatet med det samme, bør det sandsynligvis ikke blokere den første byte.
Databaseforespørgsler er langsomme eller uforudsigelige
Databaser forårsager ofte TTFB-problemer, fordi de opfører sig fint i udvikling og dårligt under rigtig trafik. Manglende indekser, store joins, N+1-forespørgsler, lock contention og overdimensionerede resultatsæt viser sig alle som “serveren er langsom”.
Gæt ikke her. Indsaml query timings for langsomme anmodninger. Se på p95 og p99, ikke kun gennemsnit. En side, der normalt svarer på 120 ms, men lejlighedsvis blokerer i 4 sekunder, vil stadig skabe en dårlig brugeroplevelse.
Almindelige løsninger omfatter:
- Tilføjelse eller rettelse af indekser
- Fjernelse af N+1 query-mønstre
- Caching af læsetunge data
- Paginering af store forespørgsler
- Flytning af rapporterings- eller analyseforespørgsler væk fra request time
- Fastlæggelse af fornuftige timeouts for downstream-kald
Din applikation har cold starts
Serverless og containeriserede platforme kan være fremragende, men cold starts kan skade TTFB, når trafikken kommer i bølger, eller regioner er underprovisionerede.
Hvis din første anmodning efter inaktiv tid er meget langsommere end senere anmodninger, så undersøg cold starts. Du kan have brug for provisioned concurrency, mindre bundles, færre startup-afhængigheder, varmere functions eller en anden deployment-form for latensfølsomme routes.
Dette er ikke et argument imod serverless. Det er et argument imod at lade som om runtime-modellen er usynlig.
Redirects spilder den første anmodning
Et redirect tilføjer endnu en request-response-cyklus, før browseren modtager det endelige dokument. Ét redirect fra http:// til https:// kan være uundgåeligt for gamle links, men kæder er spild.
Almindelige kæder omfatter:
http://example.com→https://example.com→https://www.example.com- normalisering af trailing slash efter protokolnormalisering
- geo- eller sprogressourceredirects før cacheopslag
- ældre kampagnelinks, der hopper gennem flere URLs
Ret kildelinks, hvor det er muligt, saml redirect-regler, og gør kanoniske URLs direkte. Redirect-tid rapporteres ikke altid som TTFB for den endelige anmodning, men brugeren betaler stadig for den.
En praktisk debugging-sekvens
Når TTFB ser langsom ud, så brug denne rækkefølge. Den undgår den almindelige fejl at optimere applikationskode, før cache- og routingadfærd er bekræftet.
Step 1: Test hoveddokumentet, ikke kun hele siden
Find anmodningen om HTML-dokumentet. Notér samlet TTFB og timing-opdelingen. Gentag med og uden browsercache. Test en offentlig side, en dynamisk side og en logget side, hvis det er relevant.
Step 2: Sammenlign regioner
Kør den samme URL fra flere geografiske placeringer. Hvis de langsomme regioner korrelerer med afstand fra origin, så prioritér CDN og edge caching. Hvis alle regioner er langsomme, så se på backend-behandling og origin-kapacitet.
Step 3: Inspicér svarheadere
Kig efter cache-headere, cookies, Age, CDN-status og Vary. En manglende Age-header eller gentagne cache-misses er spor. En bred Vary: Cookie-header på offentlig HTML er ofte en cache-dræber.
Step 4: Tjek origin-timing
Tilføj server timing-instrumentering. Server-Timing-headeren kan vise backend-faser som databasetid, render-tid og upstream API-tid. Selv simple labels er nyttige:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Nu kan dine browser-timings vise, om serveren brugte 300 ms på rigtigt arbejde, eller om forsinkelsen opstod, før anmodningen nåede din applikation.
Step 5: Ret den største bekræftede forsinkelse
Det lyder indlysende, men teams retter ofte det, der er velkendt, frem for det, der er målt. Hvis cache-misses dominerer, så ret caching. Hvis databasen dominerer, så ret forespørgsler. Hvis TLS og forbindelsesopsætning dominerer for globale brugere, så ret routing, CDN-dækning eller origin-geografi.
Front-end-arbejde betyder stadig noget. Skrifttyper, billeder og JavaScript påvirker, hvad der sker, efter HTML'en ankommer. Men de er ikke erstatninger for et hurtigt første svar. Hvis du også arbejder med render performance, er web fonts stadig en af de nemmeste gevinster på mange sites, fordi de påvirker, hvor hurtigt tekst bliver brugbar, efter dokumentet ankommer.
Løsninger, der som regel virker
Cache offentlig HTML ved edge
For marketingsider, dokumentation, blogs, landing pages og kategorisider er edge caching ofte den største TTFB-forbedring. Brug korte TTL'er, hvis indhold ændrer sig ofte. Brug stale-while-revalidate, hvis let forældet indhold er acceptabelt, mens cachen opdateres i baggrunden.
Vær forsigtig med personalisering. Hvis en side varierer efter valuta, sprog, loginstatus eller eksperimentgruppe, så definér disse varianter eksplicit. Utilsigtet variation pr. bruger ødelægger cache-effektiviteten.
Flyt ikke-kritisk arbejde ud af request path
Afsendelse af e-mails, analytics-berigelse, generering af anbefalinger, webhook-kald og tung logging bør sjældent blokere den første byte. Læg dem i køer, eller kør dem, efter svaret er startet.
Reducér backend-afhængighedskæder
Parallelisér uafhængige kald. Cache svar fra langsomme API'er. Sæt timeouts. Design fallback-indhold for tjenester, der er nyttige, men ikke essentielle.
En langsom anbefalingswidget bør ikke forsinke hele produktsiden.
Placer compute tættere på brugerne
Hvis dine brugere er globale, og din origin er i én region, er latens strukturel. CDN-caching kan skjule meget af dette for offentligt indhold. For dynamisk indhold bør du overveje regionale deployments, edge rendering for egnede routes eller at flytte API'er tættere på publikum.
Hold redirects kedelige
Kanonisér URLs i ét hop. Opdatér interne links, så brugere og crawlere går direkte til den endelige destination. Auditér gamle kampagne-URLs og platformsmigreringer. Redirects er nemme at ignorere, fordi de er usynlige, når de virker, men de koster stadig tid.
Hvad du ikke skal gøre
Jag ikke et perfekt TTFB-tal for hver route. En autentificeret rapport, der udfører reel beregning, vil ikke opføre sig som et cachet blogindlæg.
Brug ikke gennemsnitlig TTFB som din eneste måling. Percentiler betyder noget. Geografi betyder noget. Sidetype betyder noget.
Antag ikke, at et CDN betyder, at din HTML er cachet. Verificér det.
Og behandl ikke TTFB som adskilt fra produktbeslutninger. Personalisering, eksperimentering, realtidslager og tredjepartstjenester har alle latensomkostninger. Nogle er det værd. Nogle er bare vane.
<!-- tool-cta:start -->
💡 Prøv dette: Når du diagnosticerer TTFB, afslører Get Headers cache-status, servertiminger og omdirigeringer, som ofte forklarer, hvor forsinkelsen kommer fra.
<!-- tool-cta:end -->
Den rolige version af planen
En langsom TTFB kan som regel løses, når du holder op med at behandle den som et vagt “serverproblem”. Mål dokumentanmodningen. Segmentér efter region og sidetype. Inspicér headere. Sammenlign klient-timing med origin-timing. Ret derefter den største bekræftede flaskehals.
De fleste sites har ikke brug for eksotisk arkitektur. De har brug for færre undgåelige cache-misses, mindre blokerende backend-arbejde, renere redirects og en klarere idé om, hvad der skal ske, før den første byte sendes.
Ofte stillede spørgsmål
Er TTFB en Core Web Vitals-måling?
Hvad er et godt TTFB-mål?
Vil tilføjelse af et CDN automatisk rette TTFB?
Kan JavaScript-optimering forbedre TTFB?
Hvorfor er min TTFB kun langsom for loggede brugere?
Kilder & videre læsning