Por qué tu Time to First Byte es lento y qué hacer al respecto
TTFB no es un único bug. Es el retraso visible causado por DNS, configuración de la conexión, enrutamiento de CDN, trabajo del servidor, fallos de caché y, a veces, una consulta lenta a la base de datos.
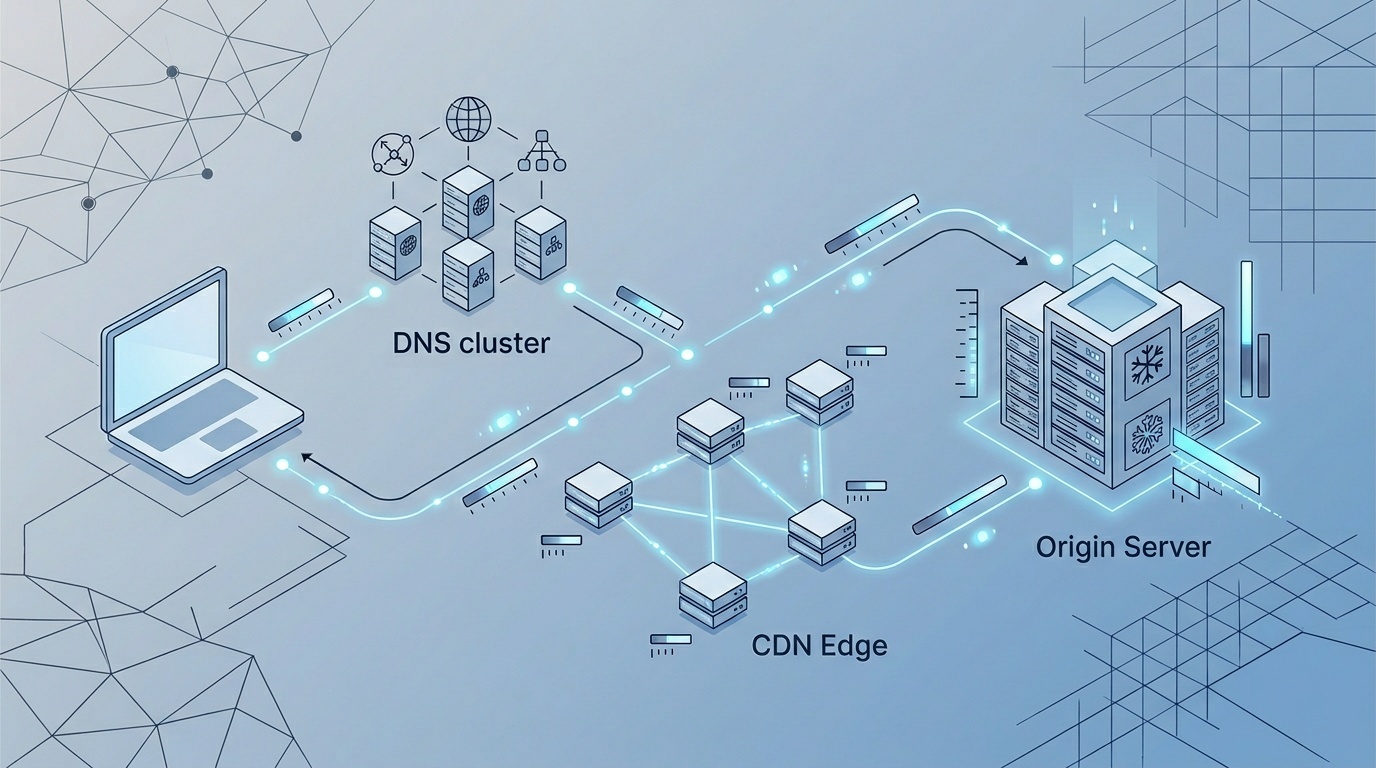
Tabla de contenido
- Empieza por lo que realmente mide TTFB
- ¿Qué se considera un TTFB lento?
- Mídelo en más de un lugar
- 1. Herramientas de desarrollo del navegador
- 2. Pruebas sintéticas desde varias regiones
- 3. Monitorización de usuarios reales o logs del servidor
- Las causas habituales de un TTFB lento
- Tu HTML no se está cacheando
- Tu CDN solo cachea recursos
- Tu servidor hace demasiado antes de responder
- Las consultas a la base de datos son lentas o impredecibles
- Tu aplicación tiene arranques en frío
- Las redirecciones desperdician la primera solicitud
- Una secuencia práctica de depuración
- Step 1: Prueba el documento principal, no solo la página completa
- Step 2: Compara regiones
- Step 3: Inspecciona las cabeceras de respuesta
- Step 4: Comprueba el tiempo del origen
- Step 5: Corrige el mayor retraso confirmado
- Correcciones que suelen funcionar
- Cachea HTML público en el borde
- Saca el trabajo no crítico de la ruta de solicitud
- Reduce las cadenas de dependencias del backend
- Acerca el cómputo a los usuarios
- Mantén las redirecciones aburridas
- Qué no hacer
- La versión tranquila del plan
Empieza por lo que realmente mide TTFB
Time to First Byte, normalmente abreviado como TTFB, es el tiempo entre que el navegador solicita un recurso y recibe el primer byte de la respuesta.
Eso suena como una métrica de servidor, pero no es solo una métrica de servidor. TTFB incluye varios pasos:
- Búsqueda DNS, si el nombre de host aún no está resuelto
- Establecimiento de la conexión TCP
- Negociación TLS para HTTPS
- Tiempo de viaje de la solicitud hasta el servidor o el borde de la CDN
- Cola y procesamiento en el servidor
- Tiempo de viaje de la respuesta de vuelta al navegador
Así que un TTFB alto puede significar que tu backend es lento. También puede significar que el usuario está lejos de tu origen, que tu CDN está mal configurada, que tu caché falla constantemente o que tu servidor tarda demasiado en decidir qué enviar.
Esto importa porque TTFB se encuentra cerca del principio de la cadena de carga. Si el documento HTML llega tarde, el navegador también descubre tarde el CSS, JavaScript, las fuentes y las imágenes. Puedes tener una excelente optimización de front-end y aun así parecer lento si la primera respuesta del documento tarda 1,5 segundos.
¿Qué se considera un TTFB lento?
No hay una cifra universal que encaje con todos los sitios, regiones y arquitecturas. Aun así, los umbrales prácticos ayudan.
La guía de web.dev de Google clasifica un buen TTFB como inferior a 800 ms, entre 800 y 1800 ms como mejorable, y por encima de 1800 ms como deficiente. Para una página de marketing bien cacheada y servida cerca del usuario, a menudo puedes hacerlo mucho mejor que eso. Para un panel autenticado complejo que realiza trabajo dinámico, la cifra aceptable puede ser mayor, pero aun así debería poder explicarse.
El hábito importante es segmentar la cifra. Un TTFB promedio global de 900 ms puede ocultar una respuesta de 150 ms para usuarios cercanos al borde de tu CDN y una respuesta de 2200 ms para usuarios en otra región. Del mismo modo, tu página de inicio puede estar bien mientras las páginas de búsqueda, categoría o con sesión iniciada son discretamente dolorosas.
Mídelo en más de un lugar
No diagnostiques TTFB a partir de una sola ejecución de Lighthouse. Lighthouse es útil, pero es una prueba desde un entorno. Si estás empezando a interpretarlo, comienza con una lectura tranquila de cómo leer un informe de Lighthouse sin entrar en pánico: la lección principal es separar las señales de laboratorio de la realidad en campo.
Para TTFB, necesitas al menos tres vistas:
1. Herramientas de desarrollo del navegador
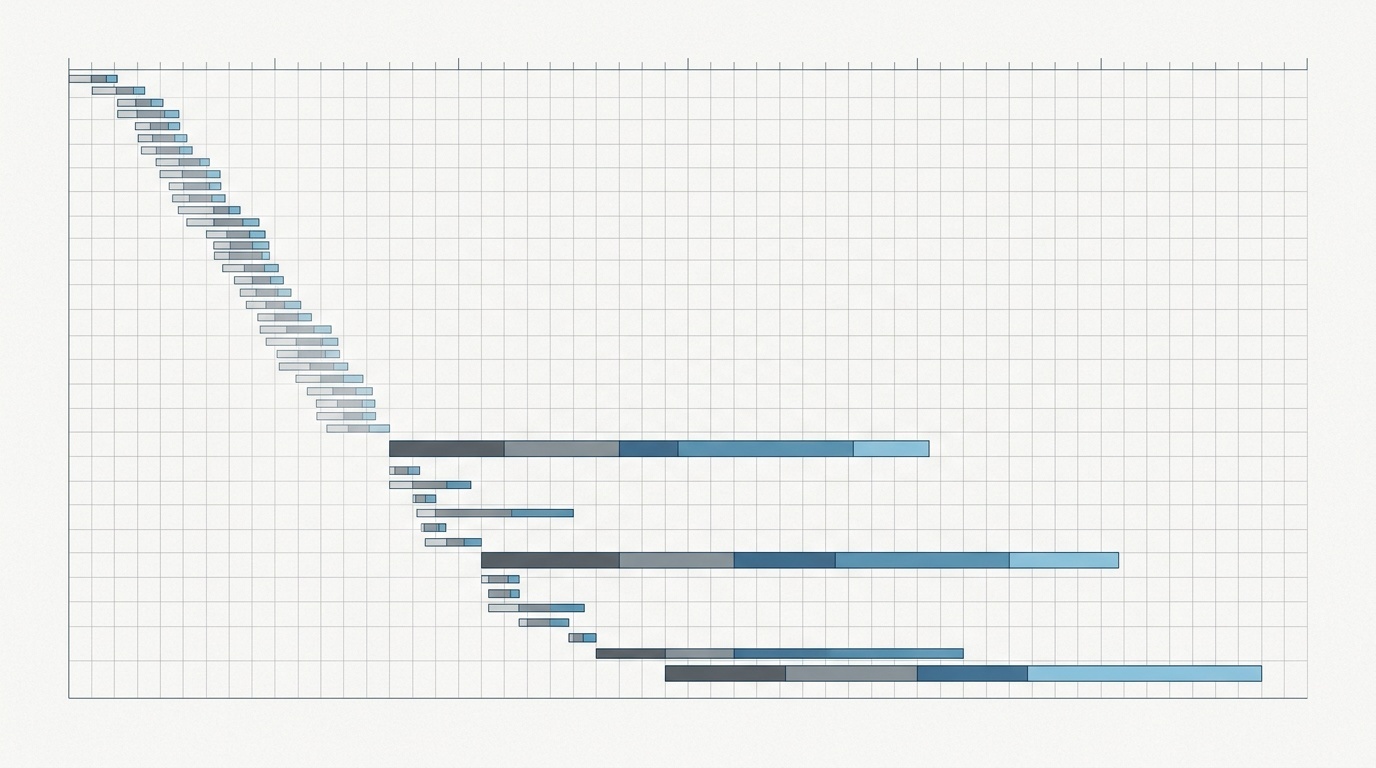
Abre el panel Network, recarga con la caché deshabilitada e inspecciona la solicitud del documento principal. El desglose de tiempos muestra las fases de DNS, conexión, TLS, espera y descarga. La fase “waiting” suele ser lo que la gente entiende por tiempo de backend, aunque puede incluir latencia ascendente.
2. Pruebas sintéticas desde varias regiones
Ejecuta pruebas desde ubicaciones cercanas y lejanas a tus usuarios. Si el TTFB es bajo en una región y alto en otra, sospecha de la geografía, el enrutamiento de la CDN, la ubicación del origen o la cobertura de caché antes de reescribir código de aplicación.
3. Monitorización de usuarios reales o logs del servidor
Los datos de campo te dicen qué experimentan los usuarios reales en distintos dispositivos, redes y sesiones. Los logs del servidor pueden decirte si el origen generó una respuesta rápidamente. La diferencia entre el TTFB observado por el cliente y el tiempo de procesamiento del origen suele ser donde aparecen los problemas de CDN y red.
Las causas habituales de un TTFB lento
Tu HTML no se está cacheando
Este es el problema más común en sitios de contenido y ecommerce. Los recursos estáticos se cachean de forma agresiva, pero el documento HTML —lo que el navegador necesita primero— se genera en cada solicitud.
A veces eso es necesario. A menudo no lo es.
Si una página pública cambia unas pocas veces al día, probablemente no debería requerir un renderizado nuevo desde la base de datos para cada visitante anónimo. Usa caché de página completa, caché en el borde, generación estática o patrones stale-while-revalidate cuando corresponda.
Revisa las cabeceras de respuesta en busca de señales como Cache-Control, CDN-Cache-Status, Age, Vary y Set-Cookie. Una página que envía una cookie única a cada visitante puede volverse accidentalmente imposible de cachear. Si necesitas una forma práctica de razonar sobre esta capa, los mismos hábitos de depuración de nuestra guía sobre redirecciones y cabeceras HTTP en producción se aplican directamente al trabajo con TTFB.
Tu CDN solo cachea recursos
Muchos equipos añaden una CDN y asumen que el trabajo de rendimiento está hecho. Pero si la CDN solo sirve imágenes, CSS y JavaScript, la primera solicitud HTML aún puede viajar hasta un único servidor de origen.
Eso puede estar bien para el sitio de un negocio local con usuarios locales. No lo está para una audiencia internacional. Cuanto más lejos esté el usuario del origen, más latencia pagas antes de que el trabajo de backend siquiera empiece.
Una buena configuración de CDN para TTFB suele significar:
- Cachear HTML público cuando sea seguro
- Respetar reglas de bypass intencionales para páginas autenticadas o personalizadas
- Evitar cabeceras
Varyinnecesarias que fragmentan demasiado la caché - Usar purga de caché o revalidación en lugar de deshabilitar la caché por completo
- Confirmar que las ubicaciones de borde realmente sirven aciertos, no que reenvían cada solicitud
Una CDN no es magia. Es una capa de caché y enrutamiento. Trátala como tal.
Tu servidor hace demasiado antes de responder
Una ruta de backend lenta puede venir de muchos pequeños retrasos: consultas a la base de datos, llamadas a API, renderizado de plantillas, comprobaciones de feature flags, autenticación, personalización, logging y arranques en frío.
El peor patrón es el trabajo con dependencias en serie. Por ejemplo:
- Obtener datos de la página
- Luego obtener productos relacionados
- Luego obtener precios
- Luego llamar a un servicio de recomendaciones
- Luego renderizar HTML
Si cada paso espera al anterior, el TTFB crece rápidamente. Paraleliza el trabajo independiente, elimina llamadas no críticas de la primera respuesta y cachea resultados costosos.
Una regla útil: si el usuario no puede ver o usar el resultado de inmediato, probablemente no debería bloquear el primer byte.
Las consultas a la base de datos son lentas o impredecibles
Las bases de datos a menudo causan problemas de TTFB porque se comportan bien en desarrollo y mal bajo tráfico real. Índices ausentes, joins grandes, consultas N+1, contención de locks y conjuntos de resultados sobredimensionados aparecen todos como “el servidor es lento”.
Aquí no adivines. Captura los tiempos de consulta de las solicitudes lentas. Mira p95 y p99, no solo promedios. Una página que normalmente responde en 120 ms pero ocasionalmente se bloquea durante 4 segundos seguirá creando una mala experiencia de usuario.
Las correcciones comunes incluyen:
- Añadir o corregir índices
- Eliminar patrones de consultas N+1
- Cachear datos con muchas lecturas
- Paginar consultas grandes
- Mover consultas de informes o analítica fuera del tiempo de solicitud
- Establecer timeouts razonables para llamadas descendentes
Tu aplicación tiene arranques en frío
Las plataformas serverless y contenerizadas pueden ser excelentes, pero los arranques en frío pueden perjudicar el TTFB cuando el tráfico llega en ráfagas o las regiones están subaprovisionadas.
Si tu primera solicitud tras un periodo de inactividad es mucho más lenta que las siguientes, investiga los arranques en frío. Puede que necesites concurrencia aprovisionada, bundles más pequeños, menos dependencias de arranque, funciones más calientes o una forma de despliegue distinta para rutas sensibles a la latencia.
Esto no es un argumento contra serverless. Es un argumento contra fingir que el modelo de ejecución es invisible.
Las redirecciones desperdician la primera solicitud
Una redirección añade otro ciclo de solicitud-respuesta antes de que el navegador reciba el documento final. Una redirección de http:// a https:// puede ser inevitable para enlaces antiguos, pero las cadenas son un desperdicio.
Las cadenas comunes incluyen:
http://example.com→https://example.com→https://www.example.com- normalización de barra final después de la normalización de protocolo
- redirecciones geográficas o de idioma antes de la búsqueda en caché
- enlaces de campañas antiguas que saltan por varias URLs
Corrige los enlaces de origen cuando sea posible, consolida las reglas de redirección y haz que las URLs canónicas sean directas. El tiempo de redirección no siempre se informa como TTFB de la solicitud final, pero el usuario sigue pagándolo.
Una secuencia práctica de depuración
Cuando el TTFB parezca lento, usa este orden. Evita el error común de optimizar código de aplicación antes de confirmar el comportamiento de caché y enrutamiento.
Step 1: Prueba el documento principal, no solo la página completa
Encuentra la solicitud del documento HTML. Registra el TTFB total y el desglose de tiempos. Repite con y sin caché del navegador. Prueba una página pública, una página dinámica y una página con sesión iniciada si es relevante.
Step 2: Compara regiones
Ejecuta la misma URL desde varias ubicaciones geográficas. Si las regiones lentas se correlacionan con la distancia al origen, prioriza CDN y caché en el borde. Si todas las regiones son lentas, mira el procesamiento de backend y la capacidad del origen.
Step 3: Inspecciona las cabeceras de respuesta
Busca cabeceras de caché, cookies, Age, estado de CDN y Vary. Una cabecera Age ausente o fallos de caché repetidos son pistas. Una cabecera amplia Vary: Cookie en HTML público suele matar la caché.
Step 4: Comprueba el tiempo del origen
Añade instrumentación de tiempos del servidor. La cabecera Server-Timing puede exponer fases del backend como tiempo de base de datos, tiempo de renderizado y tiempo de API ascendente. Incluso etiquetas simples son útiles:
Server-Timing: db;dur=82, render;dur=41, api;dur=210Ahora los tiempos del navegador pueden mostrar si el servidor dedicó 300 ms a trabajo real o si el retraso ocurrió antes de que la solicitud llegara a tu aplicación.
Step 5: Corrige el mayor retraso confirmado
Suena obvio, pero los equipos a menudo corrigen lo que les resulta familiar en lugar de lo que se ha medido. Si dominan los fallos de caché, arregla la caché. Si domina la base de datos, arregla las consultas. Si TLS y el establecimiento de conexión dominan para usuarios globales, arregla el enrutamiento, la cobertura de CDN o la geografía del origen.
El trabajo de front-end sigue importando. Las fuentes, imágenes y JavaScript afectan a lo que ocurre después de que llega el HTML. Pero no sustituyen a una primera respuesta rápida. Si también estás trabajando en el rendimiento de renderizado, las fuentes web siguen siendo una de las victorias más sencillas en muchos sitios porque afectan a la rapidez con la que el texto se vuelve usable después de que llega el documento.
Correcciones que suelen funcionar
Cachea HTML público en el borde
Para páginas de marketing, documentación, blogs, landing pages y páginas de categoría, la caché en el borde suele ser la mayor mejora de TTFB. Usa TTLs cortos si el contenido cambia con frecuencia. Usa stale-while-revalidate si un contenido ligeramente desactualizado es aceptable mientras la caché se actualiza en segundo plano.
Ten cuidado con la personalización. Si una página varía por moneda, idioma, estado de inicio de sesión o grupo de experimento, define esas variantes explícitamente. La variación accidental por usuario destruye la eficiencia de la caché.
Saca el trabajo no crítico de la ruta de solicitud
El envío de emails, el enriquecimiento analítico, la generación de recomendaciones, las llamadas webhook y el logging pesado rara vez deberían bloquear el primer byte. Ponlos en colas o ejecútalos después de que la respuesta haya empezado.
Reduce las cadenas de dependencias del backend
Paraleliza llamadas independientes. Cachea respuestas de APIs lentas. Establece timeouts. Diseña contenido de reserva para servicios que son útiles pero no esenciales.
Un widget de recomendaciones lento no debería retrasar toda la página de producto.
Acerca el cómputo a los usuarios
Si tus usuarios son globales y tu origen está en una sola región, la latencia es estructural. La caché de CDN puede ocultar gran parte de esto para contenido público. Para contenido dinámico, considera despliegues regionales, renderizado en el borde para rutas adecuadas o mover APIs más cerca de la audiencia.
Mantén las redirecciones aburridas
Canoniza URLs en un solo salto. Actualiza los enlaces internos para que usuarios y crawlers vayan directamente al destino final. Audita URLs de campañas antiguas y migraciones de plataforma. Las redirecciones son fáciles de ignorar porque son invisibles cuando funcionan, pero siguen costando tiempo.
Qué no hacer
No persigas un número de TTFB perfecto para cada ruta. Un informe autenticado que realiza cómputo real no se comportará como una entrada de blog cacheada.
No uses el TTFB promedio como tu única métrica. Los percentiles importan. La geografía importa. El tipo de página importa.
No asumas que una CDN significa que tu HTML está cacheado. Verifícalo.
Y no trates TTFB como algo separado de las decisiones de producto. Personalización, experimentación, inventario en tiempo real y servicios de terceros tienen costes de latencia. Algunos valen la pena. Otros son solo hábito.
<!-- tool-cta:start -->
💡 Prueba esto: Al diagnosticar el TTFB, Get Headers revela el estado de la caché, los tiempos del servidor y las redirecciones que a menudo explican de dónde viene el retraso.
<!-- tool-cta:end -->
La versión tranquila del plan
Un TTFB lento suele poder corregirse una vez que dejas de tratarlo como un vago “problema del servidor”. Mide la solicitud del documento. Segmenta por región y tipo de página. Inspecciona cabeceras. Compara el tiempo del cliente con el tiempo del origen. Luego corrige el mayor cuello de botella confirmado.
La mayoría de los sitios no necesitan arquitectura exótica. Necesitan menos fallos de caché evitables, menos trabajo de backend bloqueante, redirecciones más limpias y una idea más clara de qué debe ocurrir antes de enviar el primer byte.
Preguntas frecuentes
¿TTFB es una métrica de Core Web Vitals?
¿Cuál es un buen objetivo de TTFB?
¿Añadir una CDN corregirá automáticamente el TTFB?
¿Puede la optimización de JavaScript mejorar TTFB?
¿Por qué mi TTFB es lento solo para usuarios con sesión iniciada?
Fuentes y lecturas adicionales