Pourquoi votre site devrait envoyer moins de requêtes, pas seulement des requêtes plus petites
Les petits fichiers ne sont pas gratuits. Le HTTP moderne a réduit le surcoût des requêtes, il ne l’a pas rendu insignifiant.
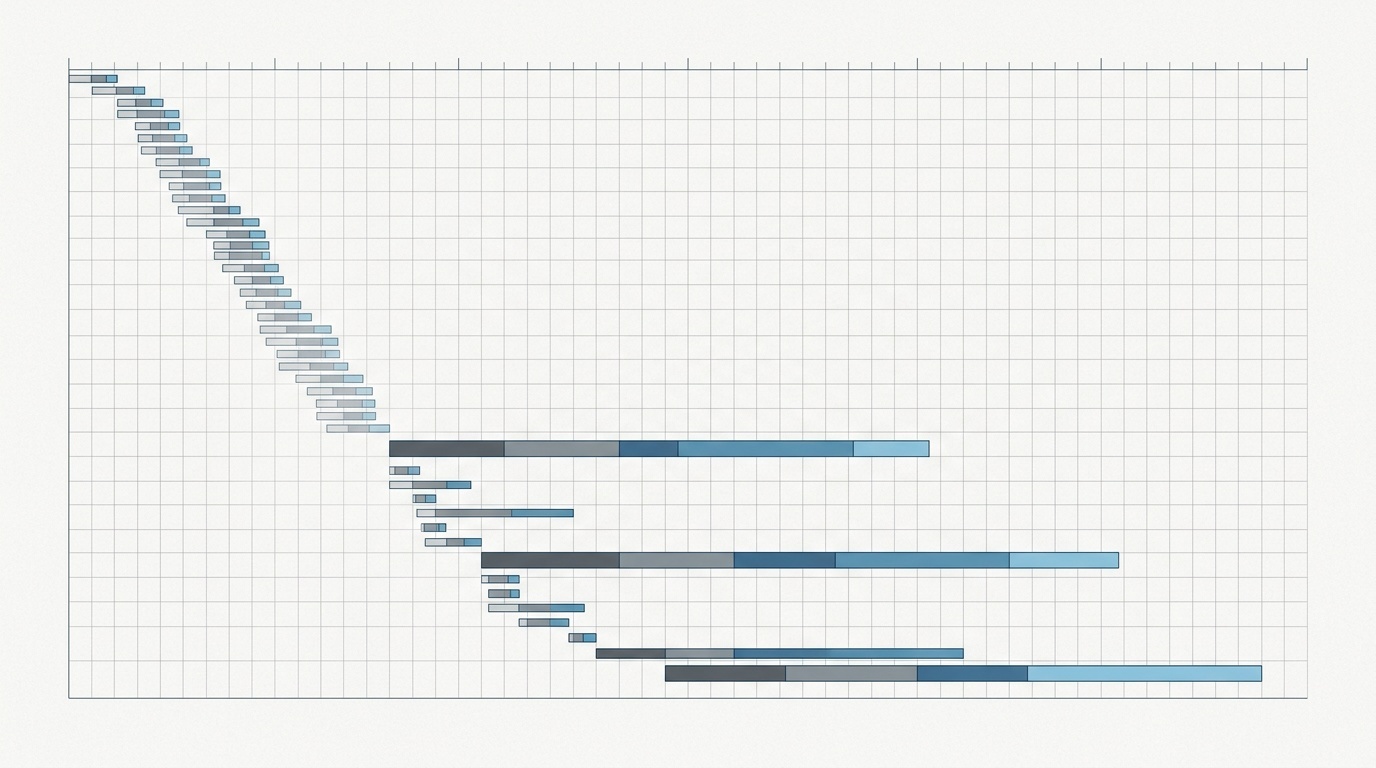
Table des matières
- Le mythe confortable du « il suffit de rendre chaque fichier plus petit »
- Les requêtes ne sont pas seulement des octets
- « Mais HTTP/2 a réglé ça », pas vraiment
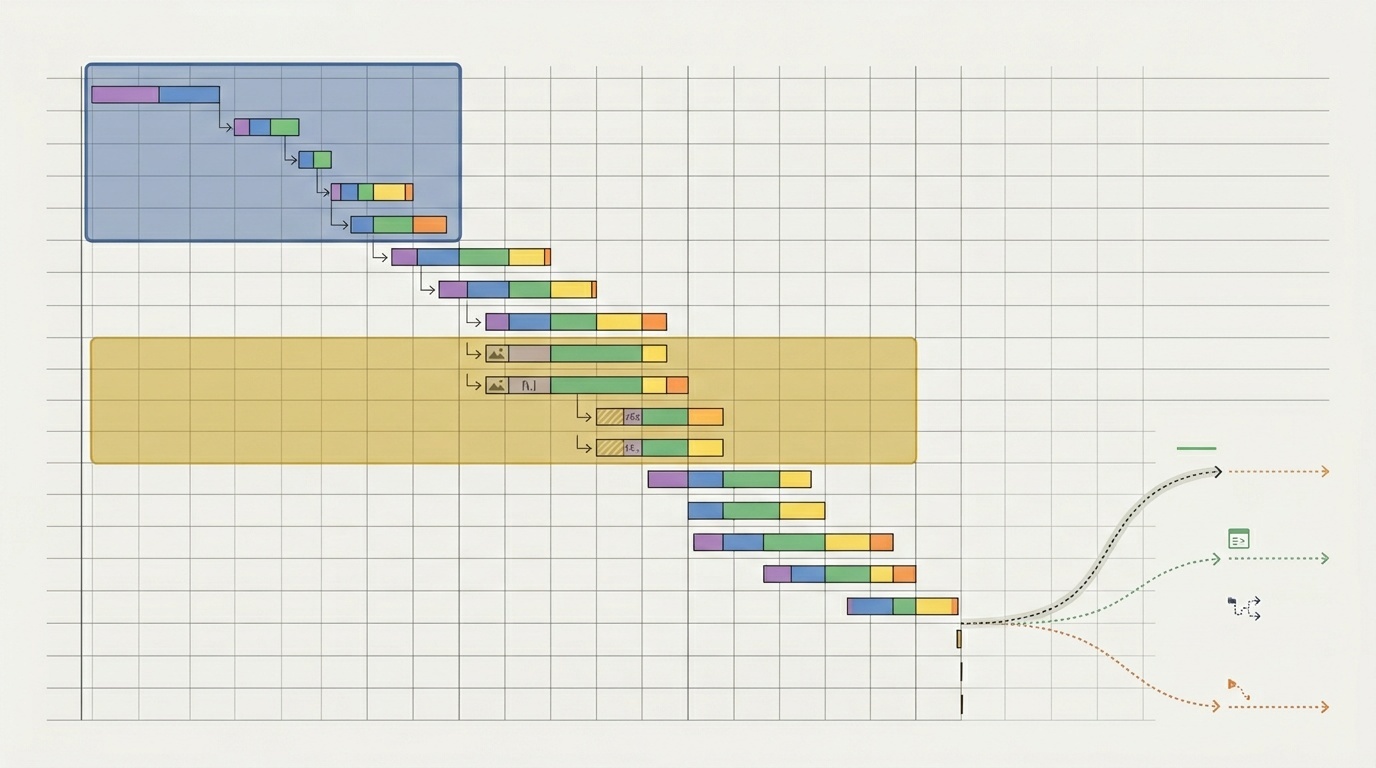
- La cascade est là où se trouve la vérité
- Les fichiers plus petits comptent toujours — mais pas tous de la même façon
- Les coûts cachés de nombreux petits fichiers
- 1. Découverte tardive
- 2. Surcoût des en-têtes
- 3. Interruption du thread principal
- 4. Complexité du cache
- Le bundling est de retour, mais avec discernement
- Les requêtes tierces méritent une suspicion particulière
- Une liste de vérification pratique pour réduire les requêtes
- Supprimer
- Combiner avec soin
- Différer
- Mettre correctement en cache
- Remesurer
- À quoi ressemble une bonne situation
Le mythe confortable du « il suffit de rendre chaque fichier plus petit »
Pendant des années, les conseils de performance web semblaient simples : compresser tout, minifier tout, réduire la taille de chaque ressource.
Ce conseil reste globalement juste. Un script de 40 Ko est généralement préférable à un script de 400 Ko. Une image optimisée vaut mieux qu’un export brut. Brotli, AVIF, la minification CSS, le tree shaking et le sous-ensemble de polices comptent tous.
Mais sur de nombreux sites en production, le problème le plus important n’est plus un fichier trop volumineux. C’est le nombre de choses que le navigateur doit demander avant que la page paraisse utilisable.
Une page peut sembler disciplinée en matière de taille de fichiers et rester lente parce qu’elle envoie 120 requêtes : fragments CSS, morceaux JavaScript, balises tierces, fichiers de polices, pixels de suivi, sprites d’icônes, endpoints JSON, preloads, balises d’analytics et revalidations de cache. Chacune peut être « petite ». Ensemble, elles créent une cascade longue et fragile.
La règle pratique est la suivante : une fois les ressources individuelles raisonnablement compressées, réduire le nombre de requêtes améliore souvent davantage l’expérience utilisateur que de retirer quelques kilooctets de chaque fichier.
Les requêtes ne sont pas seulement des octets
Une requête réseau n’est pas seulement un transfert de données. C’est une séquence de travail.
Le navigateur doit découvrir la ressource, décider quand la récupérer, la planifier par rapport aux autres ressources, envoyer des en-têtes, attendre le serveur, recevoir des en-têtes, analyser la réponse, souvent la décompresser, puis en faire quelque chose d’utile.
Ce « quelque chose d’utile » peut être coûteux. Un fichier JavaScript doit être analysé, compilé et exécuté. Un fichier CSS peut bloquer le rendu. Un fichier de police peut retarder la lisibilité du texte ou provoquer des décalages de mise en page. Une image peut affecter l’élément Largest Contentful Paint. Un script tiers peut apporter sa propre chaîne de dépendances.
C’est pourquoi le nombre de requêtes compte encore, même lorsque les fichiers sont petits. Un script de 3 Ko peut être pire qu’une image de 30 Ko s’il bloque le rendu, arrive tard et s’exécute sur le thread principal au mauvais moment.
Si vous lisez un rapport Lighthouse et avez l’impression d’être sanctionné par des dizaines d’avertissements séparés, commencez par regarder la cascade des requêtes plutôt que les scores individuels. Nous avons un guide pratique dans how to read a Lighthouse report without panicking, mais la version courte est : trouvez ce qui bloque le premier rendu et ce qui retarde le contenu principal.
« Mais HTTP/2 a réglé ça », pas vraiment
HTTP/2 et HTTP/3 ont changé l’économie des requêtes. Ils ont introduit le multiplexage, la compression des en-têtes et un meilleur comportement des connexions. En termes simples, les navigateurs sont devenus bien meilleurs pour envoyer plusieurs requêtes sur moins de connexions.
C’était une véritable amélioration. Elle a aussi mis fin à certaines vieilles habitudes, comme les sprites CSS extrêmes et les énormes bundles concaténés construits uniquement pour éviter les limites de connexion.
Mais HTTP/2 n’a pas rendu les requêtes gratuites.
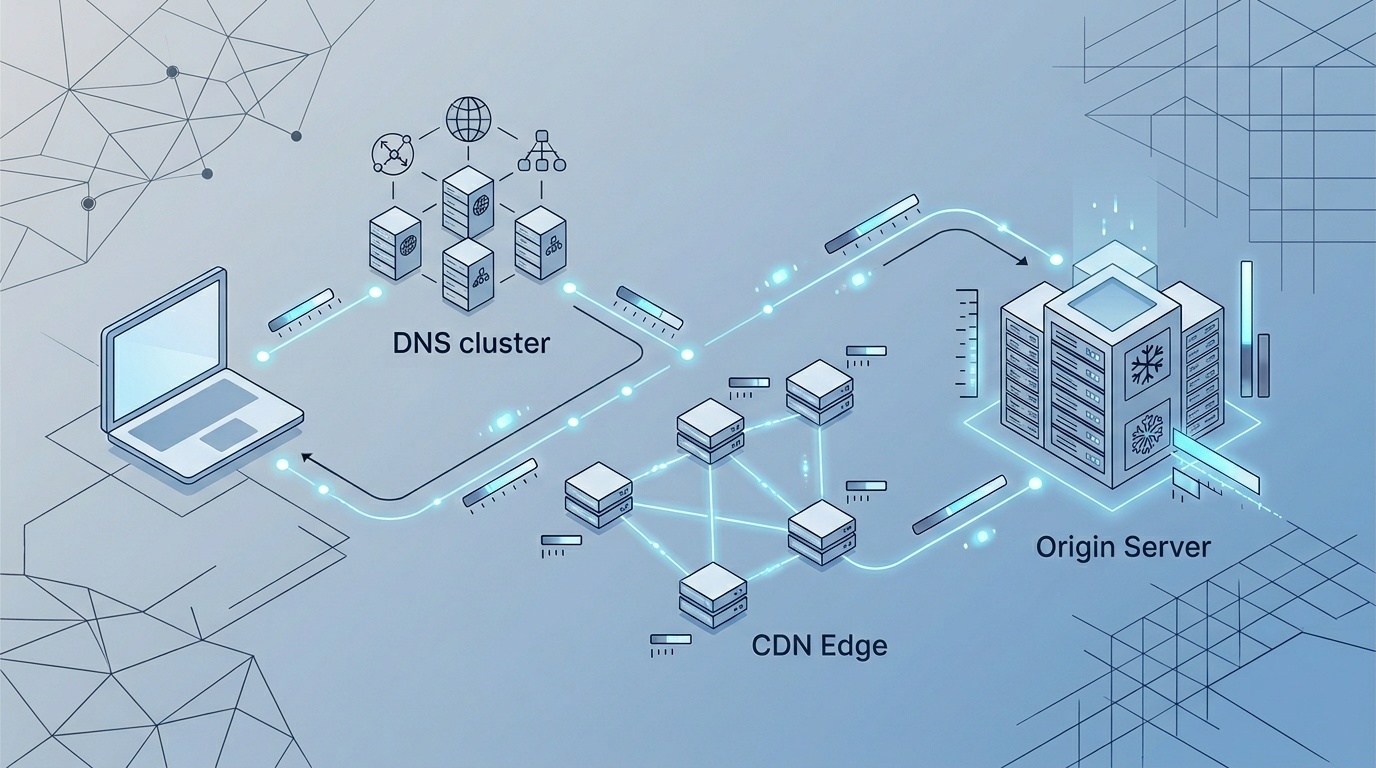
Le multiplexage aide lorsque de nombreuses ressources partagent une connexion, mais le navigateur doit toujours les prioriser. Les serveurs doivent toujours répondre. Le client doit toujours traiter chaque réponse. La congestion, la perte de paquets, la négociation TLS, la résolution DNS, les échecs de cache et la pression sur le thread principal existent toujours.
HTTP/3 améliore certains comportements de transport, notamment autour de la migration de connexion et du blocage head-of-line au niveau de la couche de transport. Il ne supprime pas le coût de la découverte, de la planification, du téléchargement, de l’analyse et de l’exécution des ressources.
L’objectif moderne n’est donc pas de « tout regrouper dans un seul fichier énorme ». C’est d’« envoyer moins de requêtes critiques, et de rendre les requêtes restantes intentionnelles ».
La cascade est là où se trouve la vérité
Les problèmes de performance s’annoncent rarement dans une seule métrique. Ils apparaissent sous forme de structure.
Ouvrez le panneau réseau d’un navigateur et regardez les premières secondes. Demandez-vous :
- Combien de requêtes démarrent avant l’apparition du contenu principal ?
- Quelles requêtes bloquent le rendu ?
- Les ressources importantes sont-elles découvertes tardivement ?
- Les scripts tiers rivalisent-ils avec le CSS, les polices ou les images de première partie ?
- De nombreux fichiers renvoient-ils des réponses 304 au lieu d’être servis directement depuis le cache ?
- Les icônes, les polices ou les fragments d’interface sont-ils divisés en plus de fichiers que la page n’en a besoin ?
Une page rapide a généralement une cascade initiale ennuyeuse. Un petit nombre de ressources critiques arrive tôt. Les ressources non critiques attendent. Les scripts tiers sont retardés, limités ou supprimés. Le navigateur n’est pas forcé de jongler avec vingt priorités avant de pouvoir peindre la page.
Une page lente a souvent une cascade nerveuse : beaucoup de petits fichiers, beaucoup d’origines et beaucoup de découvertes tardives.
Les fichiers plus petits comptent toujours — mais pas tous de la même façon
Ce n’est pas un argument contre la compression ou l’optimisation. C’est un argument contre l’optimisation des octets au détriment de la coordination.
Les fichiers plus petits comptent surtout lorsque la ressource est volumineuse, bloque le rendu ou fait partie du chemin du contenu principal. Par exemple :
- L’image hero doit être correctement dimensionnée et encodée.
- Le CSS qui bloque le rendu doit être léger.
- Le JavaScript nécessaire à la première interaction doit être minimal.
- Les polices doivent être sous-ensemblées, compressées et limitées aux graisses réellement utilisées.
Les polices en sont un exemple fréquent. Les équipes se demandent souvent si un fichier de police fait 24 Ko ou 31 Ko, tout en livrant six graisses, deux styles et plusieurs familles. La meilleure correction n’est pas de retirer 7 Ko d’un fichier. C’est d’envoyer moins de fichiers de polices. Si la typographie fait partie de votre travail de performance, les polices web restent l’un des gains les plus faciles sur la plupart des sites.
Les images suivent le même schéma. AVIF ou WebP peuvent économiser des octets importants, mais envoyer dix images décoratives au-dessus de la ligne de flottaison reste une mauvaise idée. Choisissez de meilleurs formats, oui, mais demandez-vous aussi si chaque image doit réellement être demandée. Pour les décisions de format, notre guide sur quand AVIF surpasse WebP et quand ce n’est pas le cas est un complément utile à ce travail sur le nombre de requêtes.
Les coûts cachés de nombreux petits fichiers
De nombreuses petites requêtes tendent à créer des problèmes qui n’apparaissent pas si vous regardez seulement le total des octets transférés.
1. Découverte tardive
Les navigateurs ne peuvent pas demander ce qu’ils n’ont pas découvert. Un fichier CSS peut référencer une police. Un script peut importer un autre script. Un composant peut demander du JSON après l’hydratation. Chaque dépendance ajoute une étape dans la chaîne.
Plus la chaîne est profonde, plus le travail important commence tard.
2. Surcoût des en-têtes
Chaque requête et chaque réponse inclut des en-têtes. La compression des en-têtes aide, surtout avec HTTP/2 et HTTP/3, mais elle n’élimine pas le surcoût. Les cookies peuvent aggraver fortement la situation. Si votre site envoie de gros cookies avec chaque requête, les minuscules ressources deviennent en pratique moins minuscules.
C’est l’une des raisons pour lesquelles les ressources statiques devraient souvent résider sur des chemins ou des domaines sans cookies, et pour lesquelles les en-têtes de cache méritent de l’attention. Si les en-têtes se comportent étrangement en production, déboguer les redirections et les en-têtes HTTP est généralement plus rapide que de deviner.
3. Interruption du thread principal
De nombreux morceaux JavaScript peuvent créer un travail répété d’analyse et d’exécution. Même si chaque morceau est petit, le navigateur peut devoir s’arrêter régulièrement pour évaluer du code. Cela peut nuire à Interaction to Next Paint et rendre la page saccadée.
L’utilisateur ne se soucie pas du fait que chaque fichier était petit. Il se soucie du fait qu’appuyer sur un menu a pris 600 millisecondes.
4. Complexité du cache
Diviser les ressources peut améliorer la mise en cache lorsque c’est fait avec soin. Un bundle vendor stable et un bundle applicatif changeant peuvent constituer une bonne séparation.
Mais un découpage excessif peut se retourner contre vous. Plus de fichiers signifie plus de recherches dans le cache, plus d’occasions de revalidation, plus de coordination de versions et plus de façons d’invalider accidentellement des ressources qui n’avaient pas besoin de changer.
Le bundling est de retour, mais avec discernement
La première ère de la performance web aimait le bundling parce que les navigateurs avaient des limites strictes de connexions. Puis HTTP/2 est arrivé et de nombreuses équipes ont basculé fortement vers un découpage agressif du code. Une partie était utile. Une autre est devenue une superstition.
Le juste milieu raisonnable est le bundling sensible aux routes.
Pour un site marketing ou un site de contenu typique :
- Intégrez en ligne ou chargez uniquement le CSS nécessaire au rendu initial.
- Gardez le JavaScript global léger.
- Évitez de diviser de minuscules modules en requêtes réseau séparées.
- Retardez les fonctionnalités interactives qui ne sont pas nécessaires immédiatement.
- Supprimez les scripts tiers qui ne justifient pas leur coût.
Pour une application :
- Découpez par route ou grande fonctionnalité, pas par chaque composant.
- Gardez les dépendances partagées stables et faciles à mettre en cache.
- Préchargez uniquement les ressources qui seront certainement nécessaires bientôt.
- Évitez de charger du code d’administration, de tableau de bord, d’éditeur ou d’expérimentation sur les pages publiques.
- Mesurez le coût d’interaction, pas seulement la taille du bundle.
Le bundling n’est pas automatiquement bon. Le code splitting n’est pas automatiquement bon. La question utile est : cette séparation aide-t-elle le navigateur à livrer plus tôt la prochaine expérience utilisateur significative ?
Les requêtes tierces méritent une suspicion particulière
Les requêtes de première partie sont au moins sous votre contrôle. Les requêtes tierces sont souvent plus lentes, moins prévisibles et plus coûteuses qu’elles n’en ont l’air.
Un seul tag manager peut déclencher de l’analytics, des publicités, des heatmaps, des widgets de chat, des tests A/B, des outils de consentement et des scripts de personnalisation. Chaque fournisseur peut ajouter d’autres requêtes. Certains s’exécuteront tôt. Certains bloqueront le thread principal. Certains changeront sans passer par votre processus de publication.
La meilleure optimisation des tiers est la suppression. La deuxième meilleure est le report.
Avant d’ajouter un script tiers, demandez-vous :
- Doit-il se charger avant que l’utilisateur voie la page ?
- Doit-il se charger sur chaque page ?
- Peut-il se charger après le consentement, une interaction ou un temps d’inactivité ?
- Qui en est responsable en interne ?
- Quelle métrique prouve qu’il vaut son coût en performance ?
C’est là que la performance devient une question de gouvernance. Quelqu’un doit avoir le droit de dire non.
Une liste de vérification pratique pour réduire les requêtes
Commencez par les pages les plus importantes : page d’accueil, page de tarifs, page produit, paiement, inscription ou principales pages d’atterrissage. Puis parcourez la cascade.
Supprimer
- Supprimez le JavaScript et le CSS inutilisés.
- Retirez les anciennes expériences, les pixels abandonnés et les analytics en double.
- Abandonnez les graisses de police et les bibliothèques d’icônes inutilisées.
- Remplacez les images décoratives par du CSS lorsque c’est approprié.
Combiner avec soin
- Regroupez les minuscules modules JavaScript qui se chargent toujours ensemble.
- Fusionnez les petits fichiers CSS qui bloquent le même chemin de rendu.
- Utilisez des sprites SVG ou du SVG en ligne pour les icônes répétées lorsque cela réduit les requêtes sans nuire à la maintenabilité.
Différer
- Chargez paresseusement les images sous la ligne de flottaison.
- Retardez les scripts non critiques jusqu’après le premier rendu ou une interaction utilisateur.
- Chargez les commentaires, intégrations, cartes, chats et lecteurs vidéo uniquement lorsqu’ils sont nécessaires.
Mettre correctement en cache
- Utilisez une mise en cache longue durée pour les ressources statiques versionnées.
- Évitez les revalidations inutiles pour les fichiers qui changent rarement.
- Gardez le HTML frais, mais laissez les ressources hachées rester en cache.
Remesurer
Après chaque changement, vérifiez à nouveau la cascade. L’objectif n’est pas un score parfait. L’objectif est de réduire les requêtes critiques, d’obtenir un rendu utile plus tôt et de limiter les perturbations du thread principal.
À quoi ressemble une bonne situation
Une page saine n’a pas nécessairement le plus petit nombre possible de requêtes. Elle a un chemin critique court et délibéré.
Le navigateur reçoit le HTML, le CSS essentiel, l’image du contenu principal s’il y en a une, peut-être un petit script requis pour la navigation ou une interaction au-dessus de la ligne de flottaison, et l’ensemble minimal de polices nécessaire pour rendre le texte lisible. Tout le reste attend son tour.
C’est la différence entre une page simplement optimisée et une page qui paraît rapide.
Réduire la taille des fichiers reste utile. Mais si le site est déjà raisonnablement compressé, le prochain gain de performance n’est généralement pas 2 Ko de moins dans un bundle. C’est une requête bloquante en moins, un fichier de police en moins, un script tiers en moins, une chaîne de dépendances en moins.
Moins de requêtes simplifient le travail du navigateur. La simplicité est plus souvent rapide que nous aimons l’admettre.
Questions fréquemment posées
Un seul gros bundle est-il préférable à de nombreux petits fichiers ?
HTTP/2 signifie-t-il que le nombre de requêtes ne compte plus ?
Dois-je intégrer tout le CSS critique en ligne ?
Quel est l’endroit le plus simple pour réduire les requêtes ?
Combien de requêtes une page devrait-elle avoir ?
Sources et lectures complémentaires