Wie ehrliche KI-Kennzeichnung auf einer kleinen Website aussieht
Es gibt keine juristische Vorlage dafür, Leserinnen und Lesern mitzuteilen, dass ein Modell die Worte geschrieben hat. Hier ist der redaktionelle Standard, an den wir uns halten — und warum er wichtiger ist, als Sie vielleicht denken.
 The Wux Webtools Team
4 min lesen
Inhaltsverzeichnis
Die billige Variante ist überall
Suchen Sie heute nach fast irgendeiner praktischen Frage, landen Sie auf Seiten, die von einem Sprachmodell in weniger als einer Minute zusammengesetzt wurden. Manchmal wurde das Modell gebeten, eine echte Quelle zusammenzufassen. Manchmal wurde es gebeten, eine zu erfinden. In beiden Fällen liest sich das Ergebnis plausibel, die Seite rankt ausreichend gut, und der Publisher musste keine Autorin und keinen Autor bezahlen.
Die billige Variante des KI-Publizierens hat drei gemeinsame Merkmale:
- Keine Kennzeichnung. Den Leserinnen und Lesern wird nicht gesagt, dass die Seite von einem Modell geschrieben wurde.
- Keine Bearbeitung. Der Text wurde so veröffentlicht, wie das Modell ihn erzeugt hat.
- Keine Verantwortung. Kein menschlicher Name, keine Bio, niemand, dem man schreiben kann, wenn die Seite falsch ist.
Das ist schlecht für die Leserinnen und Leser, schlecht für das offene Web und — etwas weniger offensichtlich — schlecht für den Publisher. Suchplattformen haben begonnen, es abzustrafen, die Leserschaft hat gelernt, es zu erkennen, und der Long-Tail-SEO-Vorteil erodiert mit jedem Quartal schneller, weil immer mehr Websites genau dasselbe tun.
Es gibt einen besseren Weg. Er ist auch nicht sehr kompliziert.
Drei Verpflichtungen, die das meiste abdecken
Wir verwenden auf dieser Website für einige unserer Texte Sprachmodelle — meistens als schnelles Werkzeug für einen ersten Entwurf, gelegentlich für Übersetzungen, nie für die Faktenrecherche. Die folgenden Standards sind die, an die wir uns selbst halten. Wir behaupten nicht, sie seien der einzig wahre Weg; wir veröffentlichen sie, damit Sie uns daran messen können, und damit andere kleine Publisher einen Ausgangspunkt haben.
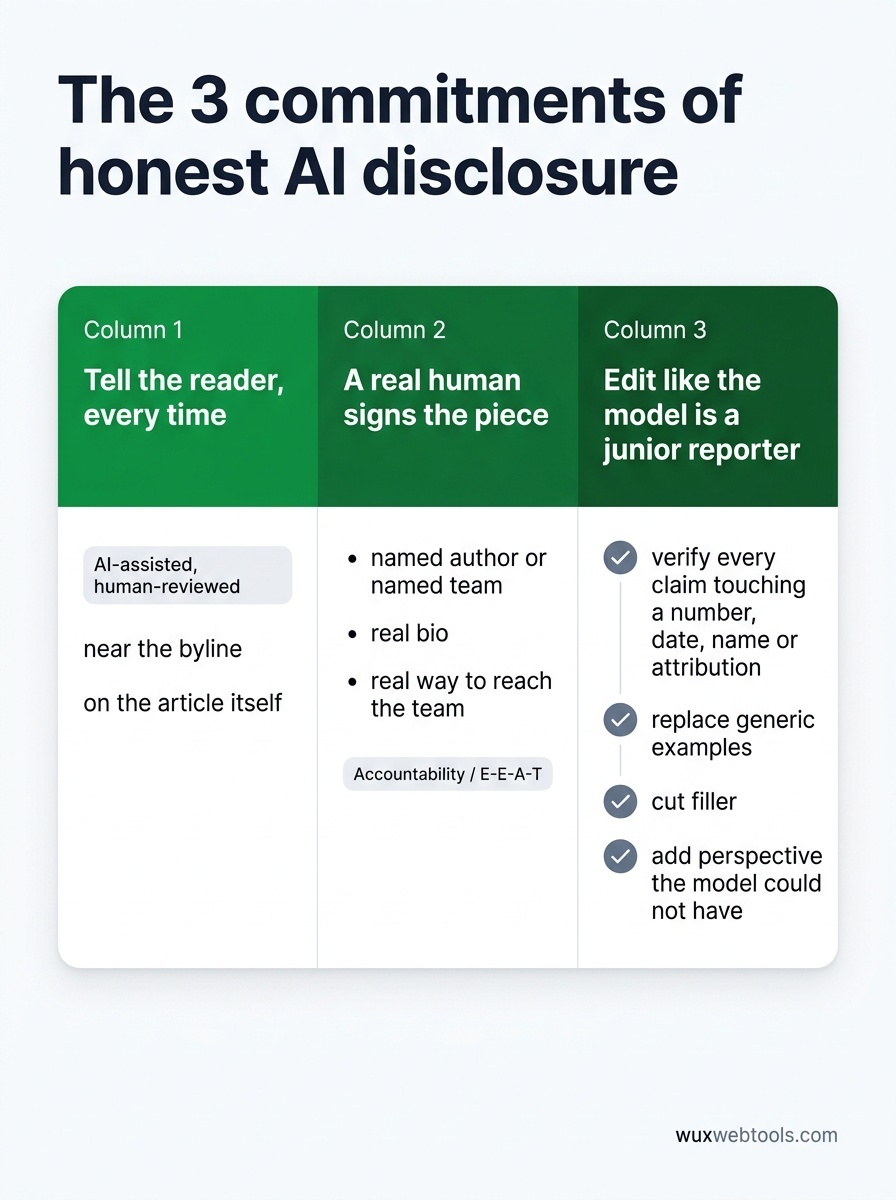
1. Informieren Sie die Leserinnen und Leser, jedes Mal
Wenn ein Modell den ersten Entwurf eines Artikels geschrieben hat, trägt der Artikel ein kleines Badge in der Nähe der Autorenzeile, das genau das sagt. Nicht versteckt in einer Datenschutzerklärung. Nicht in einem seitenweiten Footer. Auf dem Artikel selbst, dort, wo die Leserinnen und Leser es sehen, bevor sie den Worten vertrauen.
Das Badge sagt nicht „100 % KI-generiert“, weil das irreführend wäre — jeder Artikel wird auch menschlich bearbeitet. Es sagt etwas Ehrliches wie „KI-unterstützt, menschlich geprüft“, mit einem Link zu einer Seite, die genau erklärt, was das bedeutet.
2. Ein echter Mensch zeichnet den Beitrag
Jeder Artikel hat eine namentlich genannte Autorin oder einen namentlich genannten Autor mit echter Bio, echter Expertise und einer echten Möglichkeit, das Team zu erreichen. Selbst wenn die Autorenzeile kollektiv ist („The Wux Webtools Team“), ist das Team identifizierbar, die redaktionellen Standards sind schriftlich festgehalten, und es gibt eine Person, die für das Veröffentlichte verantwortlich ist.
Das ist auch der Teil, der die Seiten Authoritativeness und Trust von E-E-A-T erfüllt. Suchmaschinen achten inzwischen darauf. Gute Leserinnen und Leser ebenfalls.
3. Redigieren Sie, als wäre das Modell ein Junior-Reporter
Ein Sprachmodell ist ein schneller, selbstbewusster, leicht unzuverlässiger Schreiber. Es produziert glatte Prosa mit einer falschen Tatsache darin und warnt nie davor. Der Redigierdurchgang ist deshalb nicht optional; er ist der eigentliche Punkt.
Eine echte Bearbeitung bedeutet:
- Jede Behauptung zu verifizieren, die eine Zahl, ein Datum, einen Namen oder eine Zuschreibung betrifft.
- Generische Beispiele zu ersetzen durch solche, die das Team tatsächlich in der Praxis gesehen hat.
- Fülltext zu kürzen. Modelle lieben Übergänge über drei Sätze; Leserinnen und Leser nicht.
- Eine Perspektive hinzuzufügen, die das Modell nicht haben kann. „Nach unserer Erfahrung …“ ist der teuerste Satz im KI-unterstützten Schreiben, weil man diese Erfahrung tatsächlich haben muss.
Wenn der Artikel diesen Durchgang nicht übersteht — wenn die Aufgabe der Redaktion hauptsächlich kosmetisch ist —, sollte der Artikel nicht veröffentlicht werden. Besser zehn ehrliche Stücke pro Quartal als fünfzig glatte, aber dünne.
Wie das auf der Seite aussieht
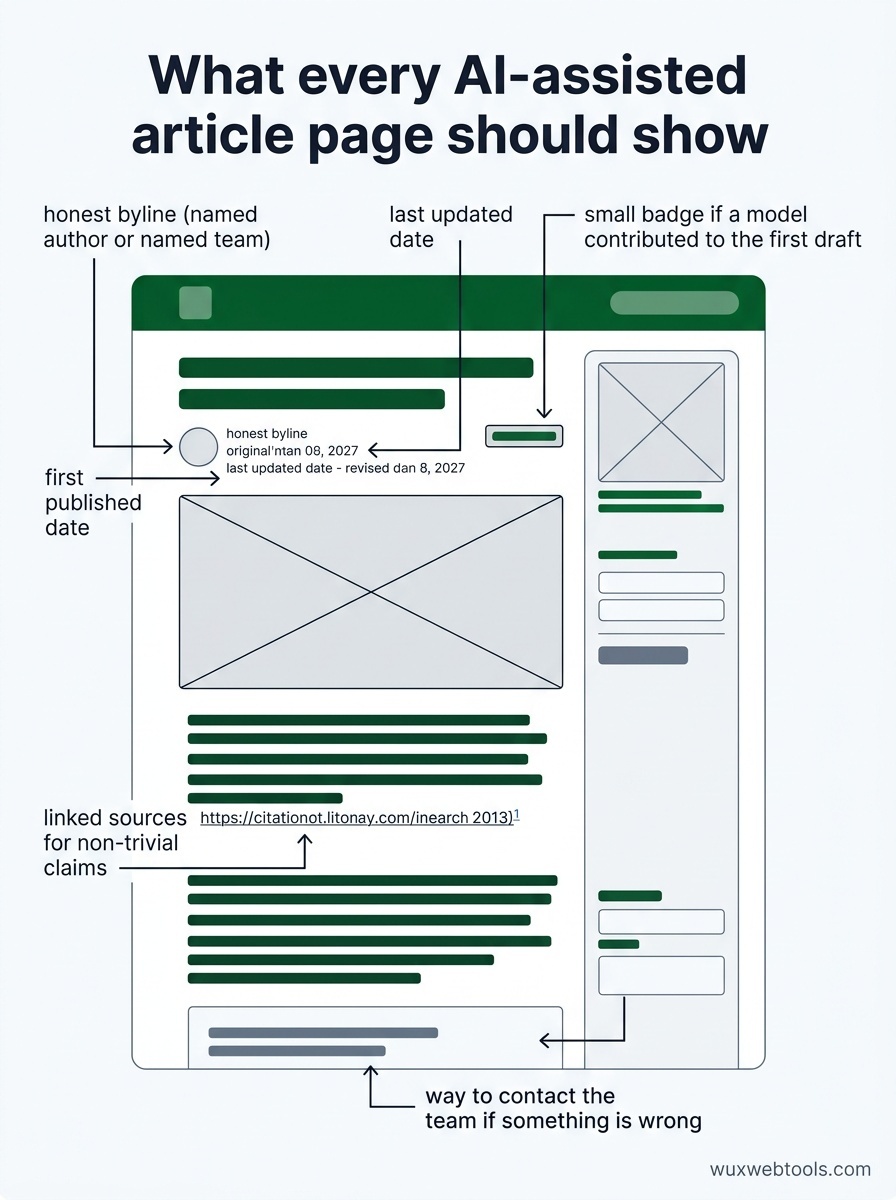
Für alle Leserinnen und Leser, die den Standard überprüfen möchten, sollte jeder Artikel in diesem Blog Folgendes zeigen:
- Eine ehrliche Autorenzeile (namentlich genannte Person oder namentlich genanntes Team)
- Das Datum der Erstveröffentlichung und das Datum der letzten Aktualisierung
- Ein kleines Badge, wenn ein Modell zum ersten Entwurf beigetragen hat
- Verlinkte Quellen für nicht triviale Behauptungen
- Eine Möglichkeit, das Team zu kontaktieren, falls etwas falsch ist
Wenn bei einem Beitrag, den Sie gerade lesen, etwas davon fehlt, sagen Sie uns bitte Bescheid — das ist ein Fehler in unserem Prozess, keine bewusste Entscheidung.
<!-- tool-cta:start -->
💡 Probieren Sie dies aus: Wenn Sie sehen möchten, wie sichtbar Ihre KI-Hinweise für Crawler sind, prüft der AI Markdown Checker, wie eine Seite die Beteiligung von KI signalisiert.
<!-- tool-cta:end -->
Der tiefere Grund
Es ist verlockend, KI-Kennzeichnung als defensiven Schritt zu betrachten: Suchmaschinen zufriedenstellen, Gegenwind vermeiden, ein Compliance-Kästchen abhaken. Dieser Blick verfehlt den Punkt.
Der eigentliche Grund für Kennzeichnung ist, dass der Vertrauensvertrag zwischen Leserschaft und Publisher das Wertvollste ist, was eine kleine Website besitzt. Menschen schenken Ihnen ein paar Minuten ihrer Aufmerksamkeit. Sie nehmen ernst, was Sie sagen, manchmal ernst genug, um danach zu handeln. Wenn sie später herausfinden, dass die Autorenzeile eine Fiktion war — dass kein Mensch wirklich hinter diesen Sätzen stand —, verlieren sie nicht nur das Vertrauen in Sie. Sie verlieren Vertrauen in das Medium. Und dieser Verlust summiert sich über das gesamte offene Web hinweg.
Ein kurzer, ehrlicher Satz auf jeder KI-unterstützten Seite ist die günstigste Versicherung dagegen.
Häufig gestellte Fragen
Muss ich kennzeichnen, wenn ich KI nur für Grammatikprüfungen verwendet habe?
Schadet Kennzeichnung nicht meinem SEO?
Was ist mit Übersetzungen?
Was ist E-E-A-T und warum taucht es ständig auf?
Quellen & weiterführende Literatur