Какие данные AI-чатботы на самом деле сохраняют из ваших разговоров
Практическое руководство по промптам, файлам, метаданным, памяти, обучающим данным и тому, о чем обычно забывают.
Содержание
- Краткая версия: больше, чем поле для сообщения
- Основные категории данных, которые чатботы могут хранить
- 1. Содержимое разговоров
- 2. Загруженные файлы, изображения, аудио и скриншоты
- 3. Данные учетной записи и идентификации
- 4. Метаданные и телеметрия
- 5. Обратная связь и заметки ручной проверки
- 6. Память и данные персонализации
- Используются ли ваши данные для обучения AI-моделей?
- Что обычно означает «удалить»
- Приватный режим, временный чат и incognito — не одно и то же
- Особый случай: plugins, connectors и custom bots
- Что частным пользователям не стоит вводить в чатботы
- Что командам следует делать вместо того, чтобы притворяться, что этого не происходит
- Разумная ментальная модель
Краткая версия: больше, чем поле для сообщения
Когда люди спрашивают, «сохраняет» ли AI-чатбот их разговоры, обычно они имеют в виду: будет ли кто-то обучать модель на том, что я только что ввел?
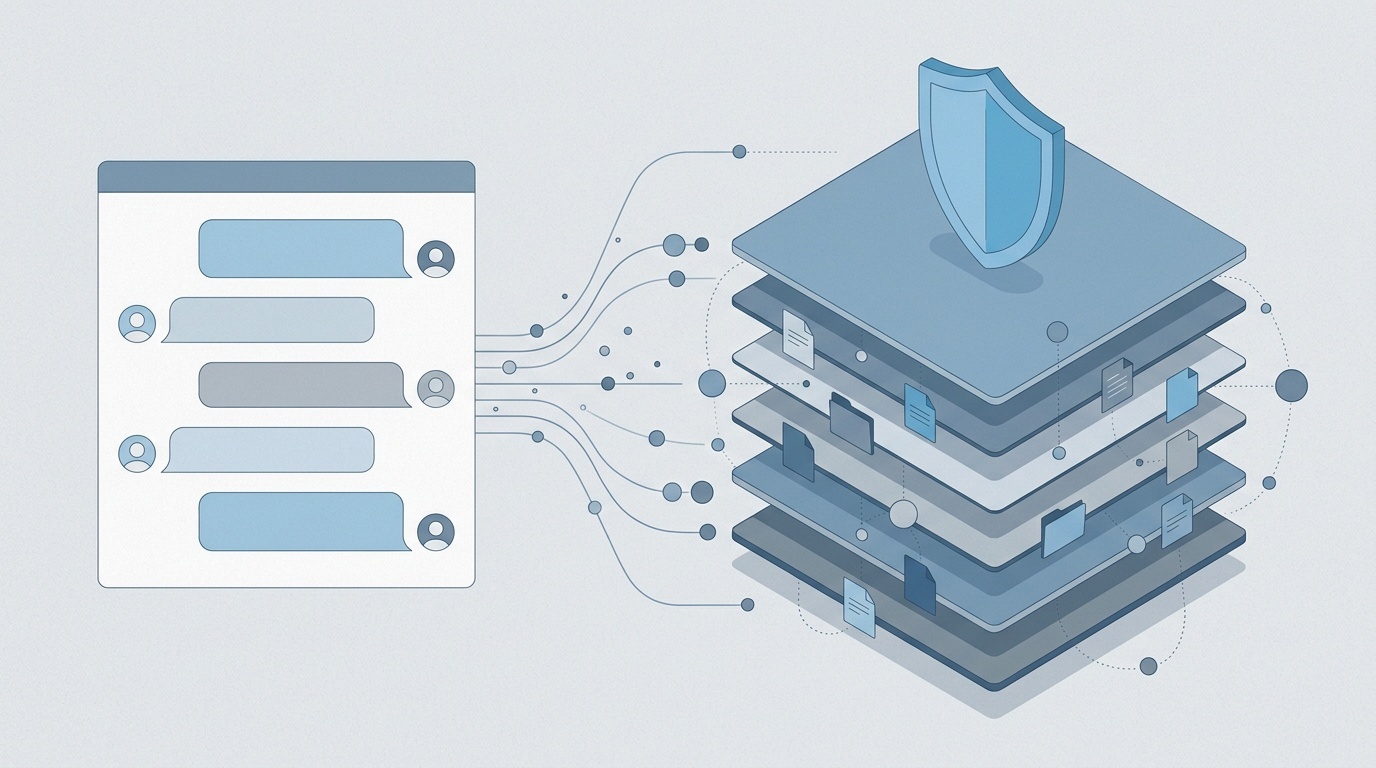
Это важный вопрос, но он слишком узкий. Современные AI-чат-продукты могут сохранять несколько слоев информации: ваши промпты, ответы модели, загруженные файлы, данные учетной записи, метаданные устройства и сети, обратную связь, журналы выявления злоупотреблений, а иногда и отдельный профиль «памяти» о вас.
Точный ответ зависит от провайдера, уровня продукта, настроек администратора, региона, а также от того, используете ли вы потребительское приложение, API или корпоративное рабочее пространство. Политики тоже меняются. Тем не менее общая картина достаточно устойчива, чтобы ее можно было анализировать.
Основные категории данных, которые чатботы могут хранить
1. Содержимое разговоров
Это очевидная часть: текст, который вы вводите, и ответ, который получаете. Если вы просите чатбот переписать клиентский договор, проанализировать таблицу, кратко изложить медицинские заметки или отладить проприетарный код, это содержимое может быть сохранено как часть истории чата или служебных журналов.
Многие продукты позволяют удалять разговоры из видимого интерфейса. Это не всегда означает немедленное удаление из каждой backend-системы. Данные могут временно оставаться в резервных копиях, системах аудита, журналах мониторинга злоупотреблений или системах юридического сохранения данных. Распространенная схема такова: быстрое удаление из пользовательского интерфейса, затем удаление из операционных систем после периода хранения, а резервные копии истекают позже.
Практический вывод: относитесь ко всему, что вставляете в чатбот, как к информации, раскрытой стороннему обработчику, если только ваш договор, настройки и рабочий процесс не говорят обратного.
2. Загруженные файлы, изображения, аудио и скриншоты
Чатботы давно перестали быть просто текстовыми полями. Пользователи загружают PDFs, CSVs, презентации, скриншоты, голосовые заметки, фотографии и репозитории кода. Эти файлы могут содержать гораздо более чувствительные данные, чем сам промпт.
Пользователь может написать: «кратко изложи это», тогда как загруженный PDF содержит имена клиентов, счета, адреса, внутренние маржи или заметки об эффективности сотрудников. Изображение может включать метаданные местоположения, метаданные устройства или видимые личные детали на заднем плане. Если ваша команда использует изображения на входе, наше руководство по удалению EXIF-метаданных перед публикацией фотографий онлайн поможет сформировать полезную привычку даже за пределами AI-процессов.
Некоторые сервисы обрабатывают файлы только в рамках текущей сессии. Другие сохраняют их вместе с разговором, хранят извлеченный из них текст или используют их для улучшения систем в зависимости от настроек. Важное различие не в том, «файл это или промпт», а в том, хранит ли провайдер исходное содержимое, извлеченное содержимое, embeddings, summaries или все перечисленное.
3. Данные учетной записи и идентификации
Если вы вошли в систему, у чатбота обычно есть данные уровня учетной записи: адрес электронной почты, имя, организация, уровень подписки, платежная информация, членство в рабочем пространстве и настройки администратора. В бизнес-продуктах также могут храниться роль, отдел, домен, идентификаторы single sign-on и события аудита.
Это важно, потому что журналы разговоров — не изолированные обрывки текста. Они часто привязаны к пользователю, рабочему пространству, организации, тарифу и временной метке. Такая привязка полезна для безопасности, поддержки, предотвращения злоупотреблений, биллинга и соблюдения требований. Но она также делает данные более чувствительными.
4. Метаданные и телеметрия
Даже если разговор кажется безобидным, сопутствующие метаданные могут многое раскрывать. Провайдеры чатботов могут собирать IP-адрес, приблизительное местоположение, версию браузера или приложения, тип устройства, операционную систему, язык, временные метки, идентификаторы сессий, использование функций, выбранную модель, задержки, ошибки и сигналы модерации.
Это похоже на более широкую проблему конфиденциальности в вебе: содержимое — только один слой; телеметрия рассказывает свою собственную историю. Если ваша команда уже анализирует cookies, аналитику и согласие, стоит распространить этот подход и на AI-чат-продукты. Наша статья о том, что изменилось для cookies в 2026 году, описывает тот же базовый сдвиг: пользователи и регуляторы все больше обращают внимание на невидимые потоки данных, а не только на видимые формы.
5. Обратная связь и заметки ручной проверки
Когда вы нажимаете «палец вверх», «палец вниз», «пожаловаться» или «сгенерировать заново», эта обратная связь может сохраняться. В некоторых системах отдельные разговоры могут просматривать люди — для безопасности, оценки качества, расследования злоупотреблений или улучшения модели. Провайдеры обычно описывают это в уведомлениях о конфиденциальности или документации продукта, но такие формулировки часто легко пропустить.
Ручная проверка не означает, что каждый сотрудник может просматривать ваши чаты. Надежные провайдеры обычно ограничивают доступ и логируют действия проверяющих. Но «ограниченный доступ» все равно остается доступом, и командам, работающим с чувствительными данными, следует учитывать это заранее.
6. Память и данные персонализации
Многие чатботы теперь предлагают память: сохраненные факты, такие как ваше имя, предпочтения, проекты, стиль письма, диетические ограничения или повторяющиеся задачи. Это не то же самое, что история чата.
Память больше похожа на небольшой профиль, который система может повторно использовать в будущих сессиях. В зависимости от продукта ее можно редактировать, удалять или отключать. Она может быть полезной, но меняет модель конфиденциальности. Разовый чат становится частью более долгосрочного пользовательского профиля.
Риск не только в том, что чатбот помнит слишком много. Риск в том, что пользователи забывают, что именно помнит система, а затем удивляются, когда старый контекст влияет на новый ответ.
Используются ли ваши данные для обучения AI-моделей?
Иногда. Не всегда. Именно здесь важен уровень продукта.
Потребительские чатбот-продукты часто оставляют за собой право использовать разговоры для улучшения сервисов или обучения моделей, если пользователь не отключит такую настройку или не использует временный/приватный режим. Некоторые провайдеры по умолчанию исключают определенные категории, а некоторые предлагают opt-out. Детали различаются.
API и корпоративные продукты обычно устроены иначе. Многие крупные AI-вендоры заявляют, что API inputs и данные бизнес-рабочих пространств по умолчанию не используются для обучения foundation models. Корпоративные договоры могут включать более строгие обязательства, соглашения об обработке данных, варианты регионального хранения, более короткие сроки хранения, журналы аудита и административные средства управления.
Это различие важно для компаний. Разработчик, вставляющий production logs в личный аккаунт чатбота, — не то же самое, что компания, использующая корпоративный AI-сервис по согласованному договору. Если вы подозреваете, что сотрудники уже используют несанкционированные инструменты, начните с легкой инвентаризации, а не с полного запрета. Мы опубликовали аудит shadow AI из 7 вопросов именно для такой ситуации.
Что обычно означает «удалить»
Удаление — не волшебный шредер. В большинстве облачных систем данные существуют в нескольких местах: рабочей базе данных, поисковых индексах, кэшах, системах аналитики, резервных копиях, инструментах поддержки, журналах безопасности, а иногда и в downstream processing pipelines.
Хороший процесс удаления должен убрать видимый разговор и запланировать backend-удаление согласно установленной политике хранения. Но некоторые данные могут оставаться для ограниченных целей: безопасности, предотвращения мошенничества, соблюдения закона, биллинга или расследования злоупотреблений.
Это не уникально для AI. Так работает большинство серьезных облачных сервисов. Проблема в том, что разговоры с чатботами часто содержат необычно концентрированную чувствительную информацию, потому что пользователи вставляют контекст, который никогда не поместили бы в обычную веб-форму.
Приватный режим, временный чат и incognito — не одно и то же
Режим incognito в браузере в основном влияет на локальную историю браузера и cookies после завершения сессии. Он не гарантирует, что провайдер чатбота не будет хранить ваш разговор.
Собственный режим временного чата у чатбота может делать больше: например, не сохранять разговор в историю или исключать его из обучения модели. Но данные все равно могут кратковременно удерживаться для безопасности, мониторинга злоупотреблений или отладки. Внимательно читайте формулировки продукта. «Не сохраняется в истории» — не то же самое, что «не хранится нигде».
Для чувствительной работы временный режим — полезный слой, но не полноценная стратегия управления.
Особый случай: plugins, connectors и custom bots
Картина конфиденциальности усложняется, когда чатбот подключается к внешним сервисам: календарям, дискам, электронной почте, CRM-системам, репозиториям кода, инструментам веб-поиска, платформам автоматизации или custom actions.
В таких рабочих процессах ваши данные могут проходить через более чем одного обработчика. Чатбот может отправить часть вашего промпта в сторонний API, извлечь документы из рабочего пространства или запустить действие в другой системе. Политика конфиденциальности AI-провайдера — лишь одна часть цепочки.
Если вы публикуете чатбота на собственном сайте, прямо объясните, что он делает. Сообщите пользователям, что логируется, как долго хранятся разговоры, могут ли люди просматривать сообщения и передаются ли данные провайдерам моделей или другим сервисам. Тот же принцип применим к AI-сгенерированному контенту: прозрачность работает лучше всего, когда она конкретна. Наше руководство по честному раскрытию использования AI на небольшом сайте — хорошая отправная точка для написания такого уведомления без излишней театральности.
Что частным пользователям не стоит вводить в чатботы
Разумное личное правило: не вставляйте данные, которые вы не отправили бы внешнему консультанту по электронной почте на неизвестных условиях.
Будьте особенно осторожны с:
- Паролями, API keys, private keys и recovery codes
- Нередактированными списками клиентов или экспортами из CRM
- Медицинскими, юридическими, финансовыми или HR-записями
- Конфиденциальными договорами и планами поглощений
- Проприетарным исходным кодом из репозиториев с ограниченным доступом
- Данными детей или чувствительными документами, удостоверяющими личность
- Внутренними отчетами об инцидентах и журналами безопасности
Редактирование помогает, но слабое обезличивание встречается часто. Замена «Jane Smith» на «Customer A» недостаточна, если окружающие детали позволяют идентифицировать человека.
Что командам следует делать вместо того, чтобы притворяться, что этого не происходит
Использование AI-чатботов уже стало нормой во многих организациях. Выбор не в том, «использовать» или «не использовать». Выбор — управляемое использование или случайное использование.
Практичная политика должна отвечать на пять вопросов:
- Какие AI-инструменты одобрены для каких классов данных?
- Используются ли промпты и outputs для обучения модели?
- Как долго хранятся чаты, файлы и журналы?
- Кто может получать доступ к истории разговоров и журналам аудита?
- Что сотрудники должны редактировать перед использованием AI-помощи?
Для команд с повышенным риском используйте корпоративные тарифы с договорными обязательствами, административными средствами управления, single sign-on, логированием и условиями обработки данных. Для задач с более низким риском обучайте сотрудников различать публичные, внутренние, конфиденциальные и регулируемые данные. Большинство ошибок происходит из-за неоднозначности, а не злого умысла.
Разумная ментальная модель
Думайте об AI-чатботе как об облачном приложении с необычно широкими полями ввода. Оно может хранить то, что вы вводите, то, что загружаете, то, что оно генерирует, как вы им пользуетесь и что оно выводит для персонализации. Часть этих данных может улучшать сервис. Часть может храниться для безопасности. Часть может быть пригодна для обучения — в зависимости от продукта и настроек.
Это не означает, что AI-чатботы автоматически небезопасны. Это означает, что они заслуживают такого же внимания к закупкам, конфиденциальности и безопасности, какое вы уделили бы электронной почте, аналитике, ПО для клиентской поддержки или хранению документов.
Спокойная и практичная позиция такова: используйте чатботы, но перестаньте воспринимать поле промпта как приватный пузырь мыслей. Это поверхность ввода данных. Управляйте ею соответствующим образом.
Часто задаваемые вопросы
Сохраняют ли AI-чатботы все, что я ввожу?
Действительно ли удаленные данные чатбота удаляются?
Используются ли корпоративные AI-чаты для обучения моделей?
Защищает ли режим incognito в браузере разговоры с чатботом?
Как безопаснее всего использовать AI-чатботы на работе?
Источники и дальнейшее чтение