Welke data AI-chatbots daadwerkelijk bewaren uit je gesprekken
Een praktische gids voor prompts, bestanden, metadata, geheugen, trainingsdata en de onderdelen die mensen meestal vergeten.
Inhoudsopgave
- De korte versie: meer dan het berichtvak
- De belangrijkste categorieën data die chatbots kunnen opslaan
- 1. Gespreksinhoud
- 2. Geüploade bestanden, afbeeldingen, audio en screenshots
- 3. Account- en identiteitsgegevens
- 4. Metadata en telemetrie
- 5. Feedback en notities van menselijke review
- 6. Geheugen- en personalisatiedata
- Wordt je data gebruikt om AI-modellen te trainen?
- Wat “verwijderen” meestal betekent
- Privémodus, tijdelijke chat en incognito zijn niet hetzelfde
- Het speciale geval van plugins, connectors en custom bots
- Wat individuen beter niet in chatbots zetten
- Wat teams moeten doen in plaats van te doen alsof dit niet gebeurt
- Een redelijk mentaal model
De korte versie: meer dan het berichtvak
Wanneer mensen vragen of een AI-chatbot hun gesprekken “bewaart”, bedoelen ze meestal: wordt het model getraind op wat ik net heb getypt?
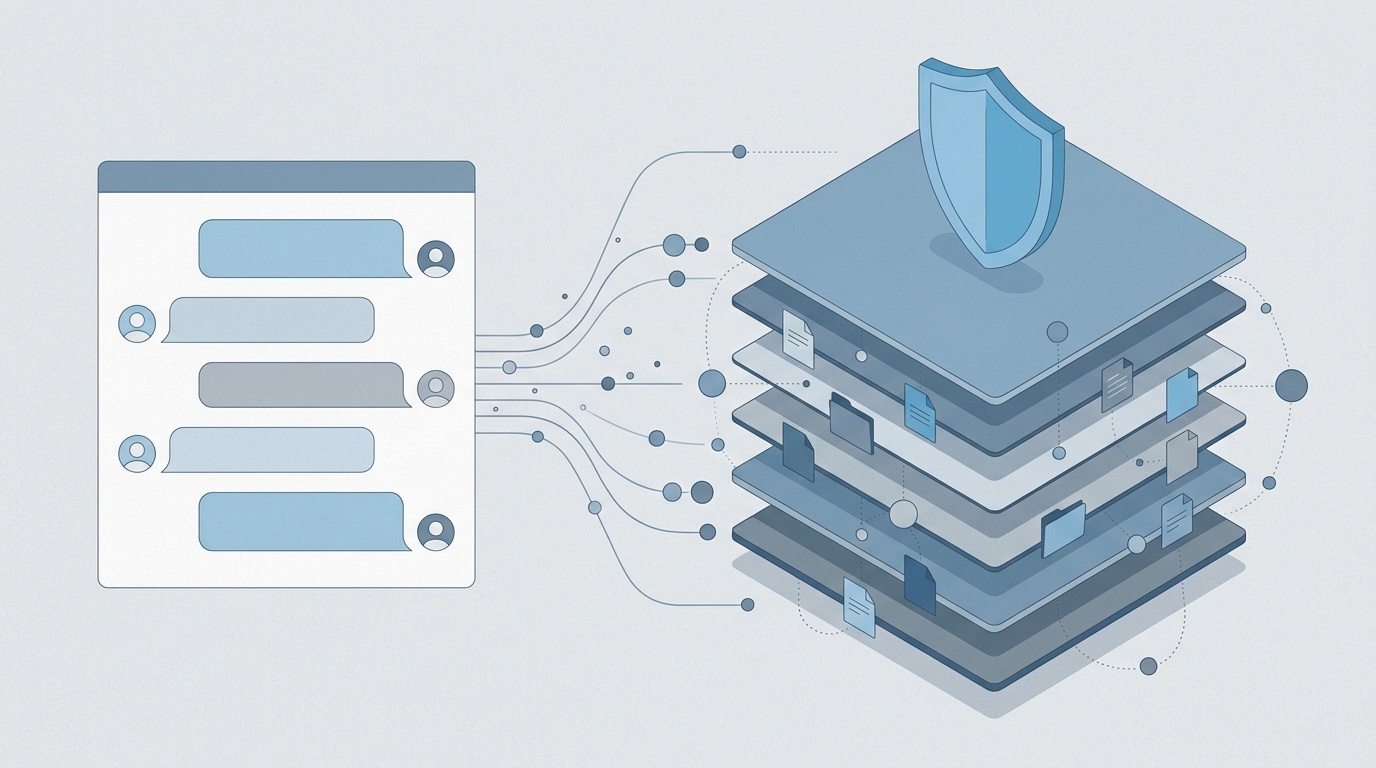
Dat is een belangrijke vraag, maar ze is te beperkt. Moderne AI-chatproducten kunnen meerdere lagen informatie bewaren: je prompts, de antwoorden van het model, geüploade bestanden, accountgegevens, apparaat- en netwerkmetadata, feedback, logs voor misbruikdetectie en soms een apart “geheugen”-profiel over jou.
Het exacte antwoord hangt af van de aanbieder, het productniveau, beheerdersinstellingen, de regio en of je een consumentenapp, API of enterprise-werkruimte gebruikt. Beleid verandert ook. Toch is het algemene patroon stabiel genoeg om erover te redeneren.
De belangrijkste categorieën data die chatbots kunnen opslaan
1. Gespreksinhoud
Dit is het voor de hand liggende deel: de tekst die je typt en het antwoord dat je ontvangt. Als je een chatbot vraagt om een klantcontract te herschrijven, een spreadsheet te analyseren, medische notities samen te vatten of propriëtaire code te debuggen, kan die inhoud worden opgeslagen als onderdeel van je chatgeschiedenis of servicelogs.
Veel producten laten je gesprekken verwijderen uit de zichtbare interface. Dat betekent niet altijd dat ze onmiddellijk uit elk backendsysteem worden verwijderd. Data kan tijdelijk blijven staan in back-ups, auditsystemen, logs voor misbruikmonitoring of systemen voor juridische bewaring. Een veelvoorkomend patroon is: snel verwijderd uit de gebruikersinterface, daarna verwijderd uit operationele systemen na een bewaartermijn, terwijl back-ups later verlopen.
Het praktische punt: behandel alles wat je in een chatbot plakt als informatie die je aan een externe verwerker verstrekt, tenzij je contract, instellingen en workflow iets anders zeggen.
2. Geüploade bestanden, afbeeldingen, audio en screenshots
Chatbots zijn niet langer tekstvakken. Gebruikers uploaden PDF’s, CSV’s, presentaties, screenshots, spraaknotities, foto’s en code-repositories. Die bestanden kunnen veel gevoeliger data bevatten dan de prompt zelf.
Een gebruiker typt misschien: “vat dit samen”, terwijl de geüploade PDF klantnamen, facturen, adressen, interne marges of notities over prestaties van medewerkers bevat. Een afbeelding kan locatiemetadata, apparaatmetadata of zichtbare persoonlijke details op de achtergrond bevatten. Als je team afbeeldingsinvoer gebruikt, is onze gids over EXIF-metadata verwijderen voordat je foto’s online deelt een nuttige gewoonte, ook buiten AI-workflows.
Sommige diensten verwerken bestanden alleen voor de directe sessie. Andere slaan ze op bij het gesprek, bewaren afgeleide tekstextracties of gebruiken ze om systemen te verbeteren, afhankelijk van de instellingen. Het belangrijke onderscheid is niet “bestand versus prompt”; het is of de aanbieder originele inhoud, geëxtraheerde inhoud, embeddings, samenvattingen of al het bovenstaande opslaat.
3. Account- en identiteitsgegevens
Als je bent ingelogd, heeft de chatbot meestal data op accountniveau: e-mailadres, naam, organisatie, abonnementsniveau, facturatiegegevens, lidmaatschap van werkruimten en beheerdersinstellingen. In zakelijke producten kan hij ook rol, afdeling, domein, single sign-on-identificatoren en auditgebeurtenissen opslaan.
Dit is belangrijk omdat gesprekslogs geen losse stukjes tekst zijn. Ze zijn vaak gekoppeld aan een gebruiker, werkruimte, organisatie, abonnement en tijdstempel. Die koppeling is nuttig voor beveiliging, support, misbruikpreventie, facturatie en compliance. Ze maakt de data ook gevoeliger.
4. Metadata en telemetrie
Zelfs als een gesprek onschuldig lijkt, kan de omringende metadata veel onthullen. Chatbotaanbieders kunnen IP-adres, geschatte locatie, browser- of appversie, apparaattype, besturingssysteem, taal, tijdstempels, sessie-identificatoren, functiegebruik, gekozen model, latency, fouten en moderatiesignalen verzamelen.
Dit lijkt op het bredere webprivacyprobleem: de inhoud is maar één laag; de telemetrie vertelt een eigen verhaal. Als je team al cookies, analytics en toestemming beoordeelt, is het de moeite waard om die manier van denken uit te breiden naar AI-chatproducten. Ons artikel over wat er in 2026 veranderde voor cookies behandelt dezelfde onderliggende verschuiving: gebruikers en toezichthouders geven steeds meer om onzichtbare datastromen, niet alleen om zichtbare formulieren.
5. Feedback en notities van menselijke review
Wanneer je op duim omhoog, duim omlaag, “rapporteren” of “opnieuw genereren” klikt, kan die feedback worden opgeslagen. In sommige systemen kunnen geselecteerde gesprekken door mensen worden beoordeeld voor veiligheid, kwaliteit, onderzoek naar misbruik of modelverbetering. Aanbieders beschrijven dit doorgaans in privacyverklaringen of productdocumentatie, maar de formulering is vaak gemakkelijk over het hoofd te zien.
Menselijke review betekent niet dat elke medewerker door je chats kan bladeren. Betrouwbare aanbieders beperken meestal de toegang en loggen revieweractiviteit. Maar “beperkte toegang” is nog steeds toegang, en teams die met gevoelige data werken moeten daar rekening mee houden.
6. Geheugen- en personalisatiedata
Veel chatbots bieden nu geheugen: opgeslagen feiten zoals je naam, voorkeuren, projecten, schrijfstijl, dieetbeperkingen of terugkerende taken. Dit is niet hetzelfde als chatgeschiedenis.
Geheugen lijkt meer op een klein profiel dat het systeem opnieuw kan gebruiken in toekomstige sessies. Het kan bewerkbaar, verwijderbaar of uitschakelbaar zijn, afhankelijk van het product. Het kan nuttig zijn, maar het verandert het privacymodel. Een eenmalige chat wordt onderdeel van een langer lopend gebruikersprofiel.
Het risico is niet alleen dat de chatbot te veel onthoudt. Het is ook dat gebruikers vergeten wat het systeem onthoudt, en vervolgens verrast zijn wanneer oude context een nieuw antwoord beïnvloedt.
Wordt je data gebruikt om AI-modellen te trainen?
Soms. Niet altijd. Hier doet het productniveau ertoe.
Consumentenproducten voor chatbots behouden zich vaak het recht voor om gesprekken te gebruiken om diensten te verbeteren of modellen te trainen, tenzij de gebruiker die instelling uitschakelt of een tijdelijke/privémodus gebruikt. Sommige aanbieders sluiten bepaalde categorieën standaard uit, en sommige bieden opt-outs. De details verschillen.
API- en enterprise-producten zijn meestal anders. Veel grote AI-leveranciers stellen dat API-invoer en data uit zakelijke werkruimten standaard niet worden gebruikt om basismodellen te trainen. Enterprise-contracten kunnen sterkere toezeggingen, verwerkersovereenkomsten, opties voor regionale opslag, kortere bewaartermijnen, auditlogs en beheerderscontroles bevatten.
Dat onderscheid is belangrijk voor bedrijven. Een ontwikkelaar die productielogs in een persoonlijk chatbotaccount plakt, is niet hetzelfde als een bedrijf dat een enterprise-AI-dienst gebruikt onder een onderhandelde overeenkomst. Als je vermoedt dat medewerkers al niet-goedgekeurde tools gebruiken, begin dan met een lichte inventarisatie in plaats van een algemeen verbod. We publiceerden een schaduw-AI-audit met 7 vragen precies voor die situatie.
Wat “verwijderen” meestal betekent
Verwijderen is geen magische papierversnipperaar. In de meeste cloudsystemen bestaat data op meerdere plekken: de live database, zoekindexen, caches, analyticssystemen, back-ups, supporttools, veiligheidslogs en soms downstream verwerkingspijplijnen.
Een goede verwijderflow zou het zichtbare gesprek moeten verwijderen en backendverwijdering moeten plannen volgens een gedefinieerd bewaarbeleid. Maar sommige data kan voor beperkte doeleinden blijven bestaan: beveiliging, fraudepreventie, juridische compliance, facturatie of onderzoek naar misbruik.
Dit is niet uniek voor AI. Zo werken de meeste serieuze clouddiensten. Het probleem is dat chatbotgesprekken vaak ongewoon geconcentreerde gevoelige informatie bevatten, omdat gebruikers context plakken die ze nooit in een normaal webformulier zouden zetten.
Privémodus, tijdelijke chat en incognito zijn niet hetzelfde
De incognitomodus van een browser beïnvloedt vooral lokale browsergeschiedenis en cookies na de sessie. Ze garandeert niet dat de chatbotaanbieder je gesprek niet opslaat.
De eigen tijdelijke chatmodus van een chatbot kan meer doen: die kan voorkomen dat het gesprek in de geschiedenis wordt opgeslagen of het uitsluiten van modeltraining. Maar data kan nog steeds kort worden bewaard voor veiligheid, misbruikmonitoring of debugging. Lees de formulering van het product zorgvuldig. “Niet opgeslagen in geschiedenis” is niet hetzelfde als “nergens bewaard”.
Voor gevoelig werk is de tijdelijke modus een nuttige laag, geen volledige governance-strategie.
Het speciale geval van plugins, connectors en custom bots
Het privacybeeld wordt ingewikkelder wanneer een chatbot verbinding maakt met externe diensten: agenda’s, drives, e-mail, CRM-systemen, code-repositories, tools voor webbrowsing, automatiseringsplatforms of aangepaste acties.
In zulke workflows kan je data via meer dan één verwerker lopen. Een chatbot kan een deel van je prompt naar een externe API sturen, documenten uit een werkruimte ophalen of een actie in een ander systeem activeren. Het privacybeleid van de AI-aanbieder is slechts één deel van de keten.
Als je een chatbot op je eigen website publiceert, zeg dan duidelijk wat hij doet. Vertel gebruikers wat wordt gelogd, hoe lang gesprekken worden bewaard, of mensen berichten kunnen beoordelen en of data wordt gedeeld met modelaanbieders of andere diensten. Hetzelfde principe geldt voor door AI gegenereerde content: transparantie werkt het best wanneer die specifiek is. Onze gids voor eerlijke AI-vermelding op een kleine website is een goed startpunt om zo’n kennisgeving te schrijven zonder theatraal te klinken.
Wat individuen beter niet in chatbots zetten
Een verstandige persoonlijke regel: plak geen data die je niet onder onbekende voorwaarden naar een externe consultant zou e-mailen.
Wees vooral voorzichtig met:
- Wachtwoorden, API-sleutels, privésleutels en herstelcodes
- Niet-geanonimiseerde klantenlijsten of CRM-exports
- Medische, juridische, financiële of HR-dossiers
- Vertrouwelijke contracten en overnameplannen
- Propriëtaire broncode uit afgeschermde repositories
- Data van kinderen of gevoelige identiteitsdocumenten
- Interne incidentrapporten en beveiligingslogs
Redactie helpt, maar zwakke redactie komt vaak voor. “Jane Smith” vervangen door “Klant A” is niet genoeg als de omringende details de persoon identificeren.
Wat teams moeten doen in plaats van te doen alsof dit niet gebeurt
Het gebruik van AI-chatbots is in veel organisaties al normaal. De keuze is niet “gebruiken” versus “niet gebruiken”. Het is beheerst gebruik versus toevallig gebruik.
Een praktisch beleid moet vijf vragen beantwoorden:
- Welke AI-tools zijn goedgekeurd voor welke dataklassen?
- Worden prompts en outputs gebruikt voor modeltraining?
- Hoe lang worden chats, bestanden en logs bewaard?
- Wie heeft toegang tot gespreksgeschiedenis en auditlogs?
- Wat moeten medewerkers redigeren voordat ze AI-assistentie gebruiken?
Voor teams met een hoger risico: gebruik enterprise-abonnementen met contractuele toezeggingen, beheerderscontroles, single sign-on, logging en verwerkingsvoorwaarden. Voor taken met een lager risico: leer medewerkers onderscheid te maken tussen publieke, interne, vertrouwelijke en gereguleerde data. De meeste fouten komen voort uit onduidelijkheid, niet uit kwade wil.
Een redelijk mentaal model
Zie een AI-chatbot als een cloudapplicatie met ongewoon brede invoervelden. Hij kan opslaan wat je typt, wat je uploadt, wat hij genereert, hoe je hem gebruikt en wat hij afleidt voor personalisatie. Een deel van die data kan de dienst verbeteren. Een deel kan worden bewaard voor beveiliging. Een deel kan in aanmerking komen voor training, afhankelijk van het product en de instellingen.
Dat betekent niet dat AI-chatbots automatisch onveilig zijn. Het betekent dat ze dezelfde aandacht verdienen op het gebied van inkoop, privacy en beveiliging als e-mail, analytics, klantenservicesoftware of documentopslag.
Het kalme, praktische standpunt is dit: gebruik chatbots, maar behandel het promptvak niet langer als een privé-gedachtenwolk. Het is een data-invoeroppervlak. Beheer het overeenkomstig.
Veelgestelde vragen
Bewaren AI-chatbots alles wat ik typ?
Is verwijderde chatbotdata echt verwijderd?
Worden enterprise-AI-chats gebruikt om modellen te trainen?
Beschermt de incognitomodus van de browser chatbotgesprekken?
Wat is de veiligste manier om AI-chatbots op het werk te gebruiken?
Bronnen & verder lezen