Cosa fanno i tag canonical quando li sbagli
I tag canonical sono utili, ma non sono innocui. Un canonical sbagliato può nascondere la pagina che volevi far posizionare, accorpare segnali nell’URL sbagliato e rendere il debug dell’indicizzazione molto più difficile del necessario.
Indice
- Il tag canonical non è un cancellino per i contenuti duplicati
- Cosa succede quando un canonical punta all’URL sbagliato
- 1. Viene indicizzato l’URL sbagliato
- 2. I segnali di ranking si consolidano nel posto sbagliato
- 3. I motori di ricerca ignorano il tag
- 4. Il debug diventa inutilmente difficile
- Gli errori canonical più costosi
- Canonicalizzare tutto verso la homepage
- Canonicalizzare le pagine paginate verso la prima pagina
- Canonicalizzare pagine filtrate senza verificare l’intento di ricerca
- Puntare i canonical a URL reindirizzati o bloccati
- Mescolare canonical e noindex come se significassero la stessa cosa
- Un audit canonical pratico
- I canonical autoreferenziali sono di solito un buon default
- I tag canonical dovrebbero corrispondere alla reale policy URL del sito
- In conclusione
Il tag canonical non è un cancellino per i contenuti duplicati
Un tag canonical indica ai motori di ricerca quale URL preferisci quando più URL contengono lo stesso contenuto, o un contenuto sostanzialmente simile. La versione HTML più comune è questa:
<link rel="canonical" href="https://example.com/preferred-page/">Esiste anche una versione come intestazione HTTP, utile soprattutto per file non HTML come i PDF:
Link: <https://example.com/preferred-file.pdf>; rel="canonical"Sembra abbastanza semplice. I problemi iniziano quando i team trattano i tag canonical come un modo sicuro per mettere ordine in qualsiasi cosa scomoda: navigazione a faccette, parametri di tracciamento, pagine stampabili, pagine prodotto quasi duplicate, paginazione, URL di staging e vecchie pagine di campagne.
I tag canonical non sono un pulsante di eliminazione. Non sono un redirect. Non sostituiscono l’architettura dell’informazione. E non è garantito che vengano rispettati.
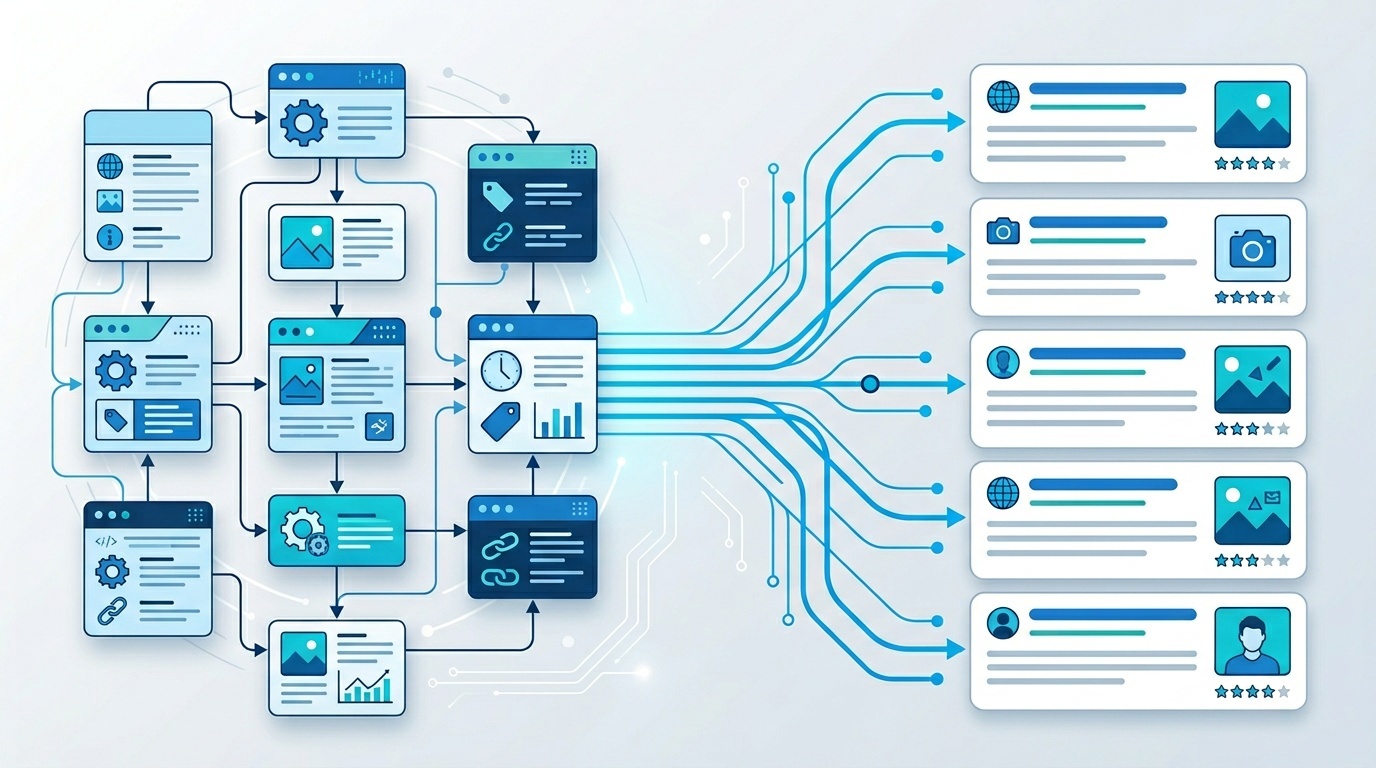
I motori di ricerca usano i canonical come indicazioni forti. Confrontano il tag canonical con altri segnali: redirect, link interni, URL nelle sitemap, annotazioni hreflang, somiglianza dei contenuti, codici di stato HTTP e gli URL che utenti e crawler incontrano davvero. Se questi segnali sono in conflitto, il motore di ricerca può ignorare il tuo canonical o scegliere un URL canonico completamente diverso.
Ecco perché sbagliare i canonical può creare tanta confusione. Il markup sembra corretto nel browser, eppure nei risultati di ricerca compare la pagina sbagliata — oppure la pagina giusta scompare.
Cosa succede quando un canonical punta all’URL sbagliato
Quando un motore di ricerca vede URL duplicati o quasi duplicati, di solito li raggruppa in un cluster e seleziona un URL come canonico. Il canonical scelto è la versione con maggiori probabilità di essere indicizzata e mostrata nei risultati di ricerca. I segnali dei duplicati possono essere consolidati in quell’URL scelto.
Se il tuo tag canonical punta alla pagina sbagliata, possono succedere diverse cose.
1. Viene indicizzato l’URL sbagliato
Supponiamo che tu abbia due URL:
/mens-running-shoes//sale/mens-running-shoes/
Se la pagina delle offerte ha un canonical verso la pagina principale della categoria, può andare bene se il contenuto è quasi identico e l’URL delle offerte è solo una versione filtrata. Ma se la pagina delle offerte ha testi unici, prodotti unici e una domanda di ricerca propria, il canonical può sopprimerla.
La pagina può comunque essere sottoposta a crawling. Può comunque essere accessibile agli utenti. Ma i motori di ricerca possono decidere di non indicizzarla separatamente perché hai detto loro che un altro URL è la versione preferita.
Questo è il problema più comune con i canonical: non un guasto tecnico clamoroso, ma una scomparsa silenziosa dall’indice.
2. I segnali di ranking si consolidano nel posto sbagliato
I canonical vengono spesso usati per consolidare segnali come link e varianti di contenuto duplicato. È utile quando i duplicati sono davvero equivalenti. È rischioso quando non lo sono.
Se un articolo del blog ha URL di tracciamento come:
/guide-to-canonical-tags/?utm_source=newsletter/guide-to-canonical-tags/?utm_source=linkedin
Allora canonicalizzarli entrambi su /guide-to-canonical-tags/ è sensato.
Ma se una versione in spagnolo, una versione stampabile con contenuti extra o una variante di prodotto con un intento diverso puntano allo stesso canonical, potresti accorpare segnali che dovrebbero restare separati. Il risultato può essere una rilevanza più debole per tutti.
I tag canonical riguardano l’equivalenza. Se due pagine soddisfano intenti di ricerca diversi, probabilmente non dovrebbero canonicalizzarsi a vicenda.
3. I motori di ricerca ignorano il tag
Un canonical non è un comando. Se il target canonical reindirizza, restituisce un 404, è bloccato, ha un noindex o contiene contenuti molto diversi, i motori di ricerca possono ignorarlo.
In un certo senso è positivo: un canonical sbagliato non distrugge sempre l’indicizzazione. Ma significa anche che non puoi dare per scontato che il tag stia facendo ciò che pensi. Una pagina può dichiarare un canonical mentre Google ne seleziona un altro.
Questo è particolarmente comune quando link interni, sitemap e canonical non concordano. Se ogni link interno punta a /product, la tua sitemap elenca /product/ e il tuo canonical punta a https://www.example.com/product?ref=main, hai creato una piccola discussione tra i tuoi stessi segnali.
I motori di ricerca sono bravi a risolvere quella discussione. Non sempre sono bravi a risolverla nel modo che intendevi.
4. Il debug diventa inutilmente difficile
I canonical sbagliati raramente falliscono in modo evidente. Producono sintomi che assomigliano ad altri problemi SEO:
- “Individuata, attualmente non indicizzata” o un equivalente limbo di indicizzazione
- L’URL sbagliato che si posiziona per una query
- URL con parametri che compaiono nei report
- Pagine di categoria che non compaiono nonostante siano accessibili ai crawler
- Pagine internazionali accorpate nella versione linguistica sbagliata
- Nuovi template lanciati con meno pagine indicizzate del previsto
Per questo il debug dei canonical dovrebbe includere HTML grezzo, HTML renderizzato, intestazioni HTTP, redirect e voci della sitemap. Se stai già indagando catene di redirect o intestazioni non coerenti, valgono le stesse abitudini; un flusso pratico di ispezione HTTP come quello nella nostra guida al debug di redirect e intestazioni HTTP in produzione di solito individua le contraddizioni nei canonical più rapidamente che fissare un campo del CMS.
Gli errori canonical più costosi
Canonicalizzare tutto verso la homepage
Succede ancora. Un campo del template resta vuoto, un plugin ripiega sulla root del sito e all’improvviso centinaia di pagine dichiarano la homepage come canonical.
I motori di ricerca possono ignorarlo perché il contenuto è palesemente diverso. Ma se abbastanza segnali sono disordinati, alcune pagine possono essere escluse o raggruppate in modo errato. Come minimo, stai inviando un’indicazione inutile e contraddittoria su ogni pagina.
La homepage non è quasi mai il canonical di una pagina interna.
Canonicalizzare le pagine paginate verso la prima pagina
Per molto tempo, alcuni siti hanno canonicalizzato /category/page/2/, /page/3/ e così via riportandoli alla prima pagina. L’intenzione era evitare pagine di categoria duplicate.
Il problema è che le pagine paginate non sono duplicati. Contengono elementi diversi e aiutano i crawler a scoprire contenuti più profondi. Canonicalizzarle tutte verso la prima pagina può ridurre la probabilità che i motori di ricerca elaborino completamente le pagine successive.
Di solito, le pagine paginate dovrebbero avere canonical autoreferenziali, a meno che non ci sia un motivo specifico per consolidarle.
Canonicalizzare pagine filtrate senza verificare l’intento di ricerca
La navigazione a faccette crea scelte difficili. Alcuni URL filtrati sono spazzatura:
?sort=price_ascending?view=grid?sessionid=123
Altri possono essere landing page preziose:
/sofas/blue//laptops/16gb-ram//hotels/paris/pet-friendly/
Regole canonical generalizzate spesso eliminano pagine di ricerca utili insieme al rumore inutile dei parametri. Prima di canonicalizzare pagine filtrate, chiediti se la pagina filtrata ha contenuti stabili, link interni, domanda di ricerca e un bisogno utente distinto.
Se la risposta è sì, potrebbe meritare di essere indicizzabile con un canonical autoreferenziale.
Puntare i canonical a URL reindirizzati o bloccati
Il target di un canonical dovrebbe essere pulito, indicizzabile e restituire 200 OK. Non puntare i canonical a URL che reindirizzano, restituiscono errori, richiedono cookie, sono bloccati da robots.txt o hanno noindex.
Questo è uno dei controlli più facili da automatizzare. Esegui un crawl del sito e segnala i target canonical che non restituiscono una risposta 200 pulita.
Mescolare canonical e noindex come se significassero la stessa cosa
rel="canonical" e noindex risolvono problemi diversi.
Usa canonical quando esistono duplicati e vuoi consolidare i segnali verso un URL preferito. Usa noindex quando non vuoi che una pagina venga indicizzata affatto.
Usarli insieme invia un messaggio scomodo: “Non indicizzare questa pagina, ma usala anche come segnale di duplicazione per un’altra pagina.” I motori di ricerca spesso riescono a gestirlo, ma non è un’istruzione pulita. Se una pagina è un duplicato, canonicalizzala. Se non dovrebbe comparire nella ricerca e non ha una relazione di duplicazione utile, considera noindex.
Un audit canonical pratico
Non serve una grande piattaforma SEO per trovare molti problemi di canonical. Inizia con un crawl, alcuni campioni di URL e un foglio di calcolo.
Per ogni template importante, verifica:
- La pagina ha esattamente un tag canonical? Più tag canonical creano ambiguità.
- Il canonical è assoluto? Usa l’URL completo, inclusi protocollo e hostname.
- Il target canonical restituisce
200 OK? Evita target reindirizzati, bloccati o in errore. - Il target canonical è indicizzabile? Nessun
noindex, nessun blocco robots, nessun requisito di autenticazione. - Il contenuto è davvero equivalente? Simile non significa sempre equivalente.
- I link interni concordano? Linka al formato URL canonico ogni volta che è possibile.
- La sitemap concorda? Le sitemap dovrebbero generalmente elencare URL canonici e indicizzabili.
- I tag hreflang concordano? Le pagine internazionali hanno bisogno di relazioni canonical e hreflang coerenti.
- L’HTML renderizzato corrisponde all’HTML grezzo? JavaScript può modificare o iniettare tag.
- Quale canonical ha scelto il motore di ricerca? Gli strumenti di ispezione possono mostrare quando il tuo canonical dichiarato differisce da quello selezionato.
Anche qui Lighthouse può essere utile, ma solo entro i suoi limiti. Può segnalare alcuni problemi di crawlability e di documento, ma non comprende il tuo intento commerciale o la tua strategia canonical. Trattalo come un input, non come una sentenza. Se ti serve un modo più calmo per separare i risultati utili dal rumore, vedi come leggere un report Lighthouse senza farsi prendere dal panico.
I canonical autoreferenziali sono di solito un buon default
Ogni pagina importante e indicizzabile dovrebbe di solito dichiarare se stessa come canonical. Non perché i motori di ricerca non possano capirlo senza il tag. Ma perché i canonical autoreferenziali riducono l’ambiguità quando parametri, link di tracciamento, URL copiati e stranezze del CMS creano percorsi alternativi verso lo stesso contenuto.
Per una pagina prodotto pulita, di solito è corretto:
<link rel="canonical" href="https://example.com/products/linen-shirt/">Per un URL di tracciamento, il canonical dovrebbe di solito puntare alla versione pulita:
<link rel="canonical" href="https://example.com/products/linen-shirt/">Per una variante prodotto davvero diversa, la risposta dipende. Se la camicia rossa, la camicia blu e la camicia nera hanno la stessa descrizione e cambia solo il colore, una sola pagina prodotto canonica può bastare. Se ogni variante ha domanda, recensioni, immagini, disponibilità e link interni separati, pagine indicizzabili separate possono avere senso.
Non esiste una regola canonical universale per le varianti. Esiste solo la domanda: queste pagine sono intercambiabili per chi cerca?
I tag canonical dovrebbero corrispondere alla reale policy URL del sito
La maggior parte dei bug canonical è il sintomo di un problema più profondo di policy URL. Il sito non ha deciso se gli slash finali contano, se gli URL in maiuscolo devono risolversi, se i parametri sono consentiti, se HTTP reindirizza a HTTPS o se www è canonico.
Scegli una versione pulita di ogni URL e fai in modo che l’intero sistema concordi:
- Reindirizza le versioni URL non preferite verso le versioni preferite.
- Linka internamente alle versioni preferite.
- Inserisci le versioni preferite nelle sitemap XML.
- Usa canonical autoreferenziali sulle pagine preferite.
- Canonicalizza solo i veri duplicati verso l’URL preferito.
Quando tutti questi segnali puntano nella stessa direzione, i tag canonical diventano noiosi. Questo è l’obiettivo.
In conclusione
I tag canonical sono potenti perché influenzano l’indicizzazione e il consolidamento dei segnali. Sono pericolosi per lo stesso motivo.
Un canonical sbagliato non rimuoverà sempre una pagina dalla ricerca. I motori di ricerca possono ignorarlo. Ma affidarsi ai motori di ricerca perché salvino segnali sbagliati non è una strategia. L’approccio più sicuro è riservare la canonicalizzazione ai duplicati reali, mantenere i target puliti e indicizzabili e fare in modo che link interni, redirect, sitemap e canonical raccontino la stessa storia.
I canonical non sono il posto in cui nascondere un’architettura disordinata. Sono il posto in cui confermare che è stata ripulita.
Domande frequenti
Un tag canonical sbagliato può deindicizzare una pagina?
La canonicalizzazione risolve una penalizzazione per contenuti duplicati?
Ogni pagina dovrebbe avere un canonical autoreferenziale?
Posso canonicalizzare le pagine paginate verso la prima pagina?
Qual è la differenza tra canonical e noindex?
Fonti e letture ulteriori