Що роблять канонічні теги, коли ви налаштовуєте їх неправильно
Канонічні теги корисні, але вони не безпечні самі по собі. Поганий canonical може приховати сторінку, яку ви хотіли ранжувати, об’єднати сигнали в неправильну URL-адресу й зробити налагодження індексації значно складнішим, ніж воно має бути.
Зміст
- Канонічний тег — це не гумка для дубльованого контенту
- Що відбувається, коли canonical вказує на неправильну URL-адресу
- 1. Індексується неправильна URL-адреса
- 2. Ранжувальні сигнали консолідуються не туди
- 3. Пошукові системи ігнорують тег
- 4. Налагодження стає зайво складним
- Найдорожчі помилки з canonical
- Канонікалізація всього на головну сторінку
- Канонікалізація пагінованих сторінок на першу сторінку
- Канонікалізація відфільтрованих сторінок без перевірки пошукового наміру
- Спрямування canonicals на редиректні або заблоковані URL-адреси
- Змішування canonical з noindex, ніби вони означають те саме
- Практичний аудит canonical
- Self-referencing canonicals зазвичай є хорошим варіантом за замовчуванням
- Канонічні теги мають відповідати фактичній URL-політиці вашого сайту
- Підсумок
Канонічний тег — це не гумка для дубльованого контенту
Канонічний тег повідомляє пошуковим системам, якій URL-адресі ви віддаєте перевагу, коли кілька URL-адрес містять однаковий або суттєво схожий контент. Поширена HTML-версія виглядає так:
<link rel="canonical" href="https://example.com/preferred-page/">Також існує версія в HTTP-заголовку, здебільшого корисна для не-HTML-файлів, як-от PDF:
Link: <https://example.com/preferred-file.pdf>; rel="canonical"Звучить досить просто. Проблеми починаються тоді, коли команди сприймають канонічні теги як безпечний спосіб упорядкувати будь-що незручне: фасетну навігацію, параметри відстеження, сторінки для друку, майже дубльовані сторінки товарів, пагінацію, staging URL-адреси та старі сторінки кампаній.
Канонічні теги — це не кнопка видалення. Це не редирект. Це не заміна інформаційної архітектури. І немає гарантії, що їх буде дотримано.
Пошукові системи використовують canonicals як сильні підказки. Вони порівнюють канонічний тег з іншими сигналами: редиректами, внутрішніми посиланнями, URL-адресами в sitemap, hreflang-анотаціями, схожістю контенту, HTTP-кодами статусу та URL-адресами, з якими фактично стикаються користувачі й краулери. Якщо ці сигнали конфліктують, пошукова система може проігнорувати ваш canonical або повністю вибрати іншу канонічну URL-адресу.
Саме тому помилки з canonicals можуть так заплутувати. Розмітка в браузері виглядає правильно, але в результатах пошуку з’являється неправильна сторінка — або правильна сторінка зникає.
Що відбувається, коли canonical вказує на неправильну URL-адресу
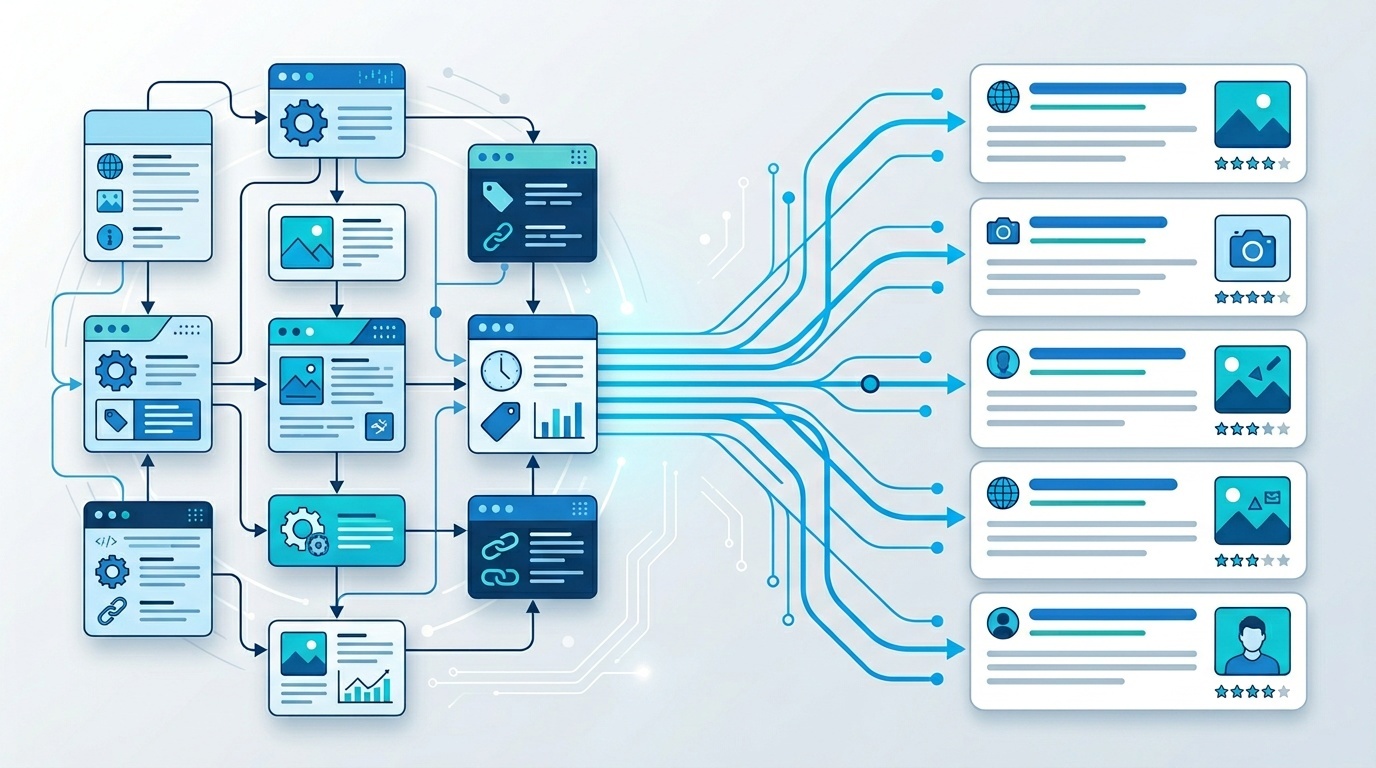
Коли пошукова система бачить дубльовані або майже дубльовані URL-адреси, вона зазвичай групує їх у кластер і вибирає одну URL-адресу як канонічну. Вибрана канонічна адреса — це версія, яка з найбільшою ймовірністю буде проіндексована й показана в результатах пошуку. Сигнали від дублікатів можуть бути консолідовані в цю вибрану URL-адресу.
Якщо ваш канонічний тег вказує на неправильну сторінку, може статися кілька речей.
1. Індексується неправильна URL-адреса
Припустімо, у вас є дві URL-адреси:
/mens-running-shoes//sale/mens-running-shoes/
Якщо сторінка розпродажу canonical-вказує на основну сторінку категорії, це може бути нормально, якщо контент майже ідентичний, а URL розпродажу — лише відфільтрована версія. Але якщо сторінка розпродажу має унікальний текст, унікальні товари й власний пошуковий попит, canonical може її приглушити.
Сторінку все ще можуть сканувати. Вона все ще може бути доступною для користувачів. Але пошукові системи можуть вирішити не індексувати її окремо, бо ви сказали їм, що інша URL-адреса є бажаною версією.
Це найпоширеніший збій canonical: не драматичний технічний інцидент, а тихе зникнення з індексу.
2. Ранжувальні сигнали консолідуються не туди
Canonicals часто використовують для консолідації сигналів, як-от посилань і варіантів дубльованого контенту. Це корисно, коли дублікати справді еквівалентні. І ризиковано, коли ні.
Якщо стаття в блозі має URL-адреси з відстеженням, наприклад:
/guide-to-canonical-tags/?utm_source=newsletter/guide-to-canonical-tags/?utm_source=linkedin
Тоді канонікалізувати обидві до /guide-to-canonical-tags/ цілком розумно.
Але якщо іспанська версія, версія для друку з додатковим контентом або варіант товару з іншим наміром вказує на той самий canonical, ви можете об’єднувати сигнали, які мали б залишатися окремими. Результатом може бути слабша релевантність для всіх них.
Канонічні теги стосуються еквівалентності. Якщо дві сторінки задовольняють різні пошукові наміри, вони, ймовірно, не повинні canonical-вказувати одна на одну.
3. Пошукові системи ігнорують тег
Canonical — це не команда. Якщо канонічна ціль редиректить, повертає 404, заблокована, має noindex або містить дуже інший контент, пошукові системи можуть її проігнорувати.
У певному сенсі це добре: поганий canonical не завжди руйнує індексацію. Але це також означає, що ви не можете припускати, ніби тег робить саме те, що ви думаєте. Сторінка може оголошувати один canonical, тоді як Google вибирає інший.
Це особливо часто трапляється, коли внутрішні посилання, sitemaps і canonicals не узгоджуються. Якщо кожне внутрішнє посилання веде на /product, ваш sitemap містить /product/, а canonical вказує на https://www.example.com/product?ref=main, ви створили невелику суперечку між власними сигналами.
Пошукові системи добре вміють розв’язувати цю суперечку. Але вони не завжди розв’язують її так, як ви задумали.
4. Налагодження стає зайво складним
Погані canonicals рідко ламаються гучно. Вони створюють симптоми, схожі на інші SEO-проблеми:
- “Discovered, currently not indexed” або еквівалентний стан індексаційної невизначеності
- Неправильна URL-адреса ранжується за запитом
- URL-адреси з параметрами з’являються у звітах
- Сторінки категорій не з’являються, хоча їх можна сканувати
- Міжнародні сторінки згортаються в неправильну мовну версію
- Нові шаблони запускаються з меншою кількістю проіндексованих сторінок, ніж очікувалося
Ось чому налагодження canonical має включати сирий HTML, відрендерений HTML, HTTP-заголовки, редиректи й записи sitemap. Якщо ви вже досліджуєте ланцюжки редиректів або невідповідні заголовки, діють ті самі звички; практичний процес HTTP-інспекції, як у нашому посібнику з налагодження редиректів і HTTP-заголовків у production, зазвичай виявляє суперечності canonical швидше, ніж вдивляння в поле CMS.
Найдорожчі помилки з canonical
Канонікалізація всього на головну сторінку
Таке досі трапляється. Поле шаблону залишається порожнім, plugin відкочується до кореня сайту, і раптом сотні сторінок оголошують головну сторінку canonical-адресою.
Пошукові системи можуть це проігнорувати, бо контент очевидно різний. Але якщо достатньо сигналів неохайні, деякі сторінки можуть бути відкинуті або неправильно кластеризовані. Щонайменше ви надсилаєте марну й суперечливу підказку на кожній сторінці.
Головна сторінка майже ніколи не є canonical для внутрішньої сторінки.
Канонікалізація пагінованих сторінок на першу сторінку
Довгий час деякі сайти канонікалізували /category/page/2/, /page/3/ тощо назад на першу сторінку. Намір полягав у тому, щоб уникнути дубльованих сторінок категорії.
Проблема в тому, що пагіновані сторінки не є дублікатами. Вони містять різні елементи й допомагають краулерам знаходити глибший контент. Канонікалізація їх усіх на першу сторінку може зменшити ймовірність того, що пошукові системи повністю опрацюють пізніші сторінки.
Зазвичай пагіновані сторінки мають мати self-referencing canonicals, якщо немає конкретної причини для консолідації.
Канонікалізація відфільтрованих сторінок без перевірки пошукового наміру
Фасетна навігація створює складні вибори. Деякі відфільтровані URL-адреси — сміттєві:
?sort=price_ascending?view=grid?sessionid=123
Інші можуть бути цінними посадковими сторінками:
/sofas/blue//laptops/16gb-ram//hotels/paris/pet-friendly/
Універсальні правила canonical часто стирають корисні пошукові сторінки разом із марним параметричним шумом. Перш ніж канонікалізувати відфільтровані сторінки, запитайте, чи має відфільтрована сторінка стабільний контент, внутрішні посилання, пошуковий попит і окрему потребу користувача.
Якщо відповідь так, вона може заслуговувати на індексацію із self-referencing canonical.
Спрямування canonicals на редиректні або заблоковані URL-адреси
Канонічна ціль має бути чистою, індексованою й повертати 200 OK. Не спрямовуйте canonicals на URL-адреси, які редиректять, повертають помилки, потребують cookies, заблоковані через robots.txt або мають noindex.
Це одна з найпростіших перевірок для автоматизації. Проскануйте сайт і позначте канонічні цілі, які не повертають чисту відповідь 200.
Змішування canonical з noindex, ніби вони означають те саме
rel="canonical" і noindex розв’язують різні проблеми.
Використовуйте canonical, коли існують дублікати й ви хочете консолідувати сигнали до бажаної URL-адреси. Використовуйте noindex, коли ви взагалі не хочете, щоб сторінка індексувалася.
Використання обох разом надсилає незграбне повідомлення: “Не індексуйте цю сторінку, але також використовуйте її як дубльований сигнал для іншої сторінки.” Пошукові системи часто можуть із цим упоратися, але це не чиста інструкція. Якщо сторінка є дублікатом, канонікалізуйте її. Якщо вона не має з’являтися в пошуку й не має корисного дубльованого зв’язку, розгляньте noindex.
Практичний аудит canonical
Вам не потрібна велика SEO-платформа, щоб знайти багато проблем із canonical. Почніть зі сканування, кількох зразків URL-адрес і spreadsheet.
Для кожного важливого шаблону перевірте:
- Чи має сторінка рівно один канонічний тег? Кілька канонічних тегів створюють неоднозначність.
- Чи є canonical абсолютним? Використовуйте повну URL-адресу, включно з протоколом і hostname.
- Чи повертає канонічна ціль
200 OK? Уникайте редиректних, заблокованих або помилкових цілей. - Чи можна індексувати канонічну ціль? Без
noindex, без блокування robots, без вимоги автентифікації. - Чи справді контент еквівалентний? Схожий не завжди означає еквівалентний.
- Чи узгоджуються внутрішні посилання? Де можливо, посилайтеся на канонічний формат URL.
- Чи узгоджується sitemap? Sitemaps загалом мають містити канонічні, індексовані URL-адреси.
- Чи узгоджуються hreflang-теги? Міжнародним сторінкам потрібні послідовні зв’язки canonical і hreflang.
- Чи збігається відрендерений HTML із сирим HTML? JavaScript може змінювати або вставляти теги.
- Який canonical вибрала пошукова система? Інструменти інспекції можуть показати, коли ваш оголошений canonical відрізняється від вибраного.
Тут Lighthouse також може бути корисним, але лише в межах своїх обмежень. Він може позначити деякі проблеми зі сканованістю та документом, але не розуміє вашого комерційного наміру чи стратегії canonical. Сприймайте його як один із вхідних сигналів, а не як вирок. Якщо вам потрібен спокійніший спосіб відокремити корисні знахідки від шуму, подивіться, як читати звіт Lighthouse без паніки.
Self-referencing canonicals зазвичай є хорошим варіантом за замовчуванням
Кожна важлива індексована сторінка зазвичай має оголошувати саму себе canonical. Не тому, що пошукові системи не можуть розібратися без цього тега. А тому, що self-referencing canonicals зменшують неоднозначність, коли параметри, посилання для відстеження, скопійовані URL-адреси й примхи CMS створюють альтернативні шляхи до того самого контенту.
Для чистої сторінки товару це зазвичай правильно:
<link rel="canonical" href="https://example.com/products/linen-shirt/">Для URL-адреси з відстеженням canonical зазвичай має вказувати назад на чисту версію:
<link rel="canonical" href="https://example.com/products/linen-shirt/">Для справді іншого варіанта товару відповідь залежить від ситуації. Якщо червона сорочка, синя сорочка й чорна сорочка мають однаковий опис і змінюється лише колір, однієї канонічної сторінки товару може бути достатньо. Якщо кожен варіант має окремий попит, відгуки, зображення, наявність і внутрішні посилання, окремі індексовані сторінки можуть мати сенс.
Універсального правила canonical для варіантів не існує. Є лише питання: чи є ці сторінки взаємозамінними для користувача пошуку?
Канонічні теги мають відповідати фактичній URL-політиці вашого сайту
Більшість помилок canonical — це симптоми глибшої проблеми URL-політики. Сайт не вирішив, чи важливі кінцеві слеші, чи мають працювати URL-адреси з великими літерами, чи дозволені параметри, чи HTTP редиректить на HTTPS, або чи www є canonical.
Виберіть одну чисту версію кожної URL-адреси й узгодьте з нею всю систему:
- Редиректьте небажані версії URL на бажані.
- Посилайтеся внутрішньо на бажані версії.
- Додавайте бажані версії в XML sitemaps.
- Використовуйте self-referencing canonicals на бажаних сторінках.
- Канонікалізуйте лише справжні дублікати до бажаної URL-адреси.
Коли всі ці сигнали вказують в одному напрямку, канонічні теги стають нудними. Саме це і є мета.
Підсумок
Канонічні теги потужні, бо впливають на індексацію й консолідацію сигналів. З тієї самої причини вони небезпечні.
Неправильний canonical не завжди прибере сторінку з пошуку. Пошукові системи можуть його проігнорувати. Але покладатися на те, що пошукові системи врятують погані сигнали, — це не стратегія. Безпечніший підхід — використовувати канонікалізацію для справжніх дублікатів, підтримувати цілі чистими й індексованими, а також зробити так, щоб ваші внутрішні посилання, редиректи, sitemaps і canonicals розповідали одну й ту саму історію.
Canonicals — це не місце, де ховають безладну архітектуру. Це місце, де підтверджують, що її вже впорядковано.
Часто задавані питання
Чи може поганий канонічний тег деіндексувати сторінку?
Чи є канонікалізація виправленням штрафу за дубльований контент?
Чи кожна сторінка має мати self-referencing canonical?
Чи можу я канонікалізувати пагіновані сторінки на першу сторінку?
У чому різниця між canonical і noindex?
Джерела та подальше читання