AI-जनरेटेड छवियों पर वॉटरमार्किंग वास्तव में क्या करती है
वॉटरमार्क प्रोवेनेंस, नीति लागू करने और disclosure में मदद कर सकते हैं। वे सिंथेटिक मीडिया को जादुई रूप से भरोसेमंद नहीं बना सकते।
सामग्री की तालिका
- वादा वास्तविकता से सरल सुनाई देता है
- पहले, वॉटरमार्क का प्रकार परिभाषित करें
- Visible watermarks
- Invisible watermarks
- Metadata और provenance records
- वॉटरमार्किंग वास्तव में क्या करती है
- 1. यह ईमानदार disclosure का समर्थन करती है
- 2. यह platforms को moderation signal देता है
- 3. यह chain of custody को संरक्षित रखने में मदद करता है
- 4. यह deception की लागत बढ़ाती है
- यह क्या नहीं करती
- यह साबित नहीं करती कि कोई image सच है
- यह attribution या copyright को हल नहीं करती
- यह हर transformation में जीवित नहीं रहती
- यह adoption के बिना काम नहीं करती
- AI images उपयोग करने वाली teams के लिए practical policy
- Detection probabilistic होनी चाहिए, moralistic नहीं
- सबसे अच्छा use case: trustworthy workflows, perfect policing नहीं
- निष्कर्ष
वादा वास्तविकता से सरल सुनाई देता है
AI छवि वॉटरमार्किंग को अक्सर सिंथेटिक मीडिया के व्यावहारिक समाधान के रूप में पेश किया जाता है: जनरेटेड छवियों को चिह्नित करें, बाद में उस चिह्न का पता लगाएँ, और दर्शकों को भरोसा दें कि वे जो देख रहे हैं वह क्या है।
यह आंशिक रूप से सही है। वॉटरमार्किंग प्लेटफ़ॉर्मों को AI-जनरेटेड छवियों पर लेबल लगाने में मदद कर सकती है, प्रकाशकों को अपने workflow का दस्तावेज़ीकरण करने में मदद कर सकती है, और जाँचकर्ताओं को कुछ मानव-निर्मित और मशीन-निर्मित assets के बीच अंतर करने में मदद कर सकती है। यह एक उपयोगी परत है।
लेकिन यह कोई सार्वभौमिक सत्य मशीन नहीं है। वॉटरमार्क हटाया जा सकता है, छूट सकता है, जाली बनाया जा सकता है, degrade हो सकता है, metadata से अलग किया जा सकता है, या screenshot से अप्रासंगिक हो सकता है। जब यह काम करता भी है, तब भी यह आमतौर पर एक सीमित प्रश्न का उत्तर देता है: क्या यह file, या इसके जैसा कुछ, ऐसे system से गुज़रा था जिसने यह mark लगाया था?
यह उन प्रश्नों का उत्तर देने से अलग है जिनकी अधिकांश लोगों को वास्तव में परवाह होती है: क्या यह छवि वास्तविक है? इसे किसने बनाया? क्या इसे edit किया गया? क्या यह भ्रामक है? क्या मुझे इसे उपयोग करने की अनुमति है?
वॉटरमार्किंग इन प्रश्नों में तभी मदद करती है जब यह व्यापक provenance और disclosure system का हिस्सा हो।
पहले, वॉटरमार्क का प्रकार परिभाषित करें
लोग watermark शब्द का उपयोग कई अलग-अलग चीज़ों के लिए करते हैं।
Visible watermarks
ये वे स्पष्ट marks हैं जो किसी छवि के ऊपर लगाए जाते हैं: logo, label, diagonal pattern, या caption जो बताता है कि छवि AI-generated थी।
Visible watermarks इंसानों के लिए समझना आसान होते हैं। उन्हें crop करना, ढकना, blur करना, या image-editing tools से हटाना भी आसान होता है। उनका मुख्य मूल्य प्रकाशन के समय disclosure है, forensic reliability नहीं।
वे तब सबसे अच्छा काम करते हैं जब publisher ईमानदार होना चाहता है। वे तब खराब काम करते हैं जब publisher धोखा देना चाहता है।
Invisible watermarks
Invisible watermarks वे signals हैं जो किसी छवि के pixels में embedded होते हैं। Detection tool बाद में जाँच सकता है कि signal मौजूद है या नहीं।
यह model SynthID जैसे systems और अन्य generator-level watermarking approaches द्वारा उपयोग किया जाता है। आकर्षण स्पष्ट है: छवि सामान्य दिख सकती है, जबकि उसमें machine-detectable signal मौजूद रहता है।
समझौता fragility का है। कुछ invisible watermarks compression, resizing, color adjustment, या mild cropping के बाद भी बने रहते हैं। अन्य नहीं रहते। Stronger marks अधिक robust हो सकते हैं, लेकिन quality को प्रभावित कर सकते हैं या adversarial attacks के प्रति vulnerable हो सकते हैं। विवरण बहुत मायने रखते हैं, और जनता शायद ही कभी इतने विवरण देख पाती है कि स्वतंत्र रूप से उनका मूल्यांकन कर सके।
Metadata और provenance records
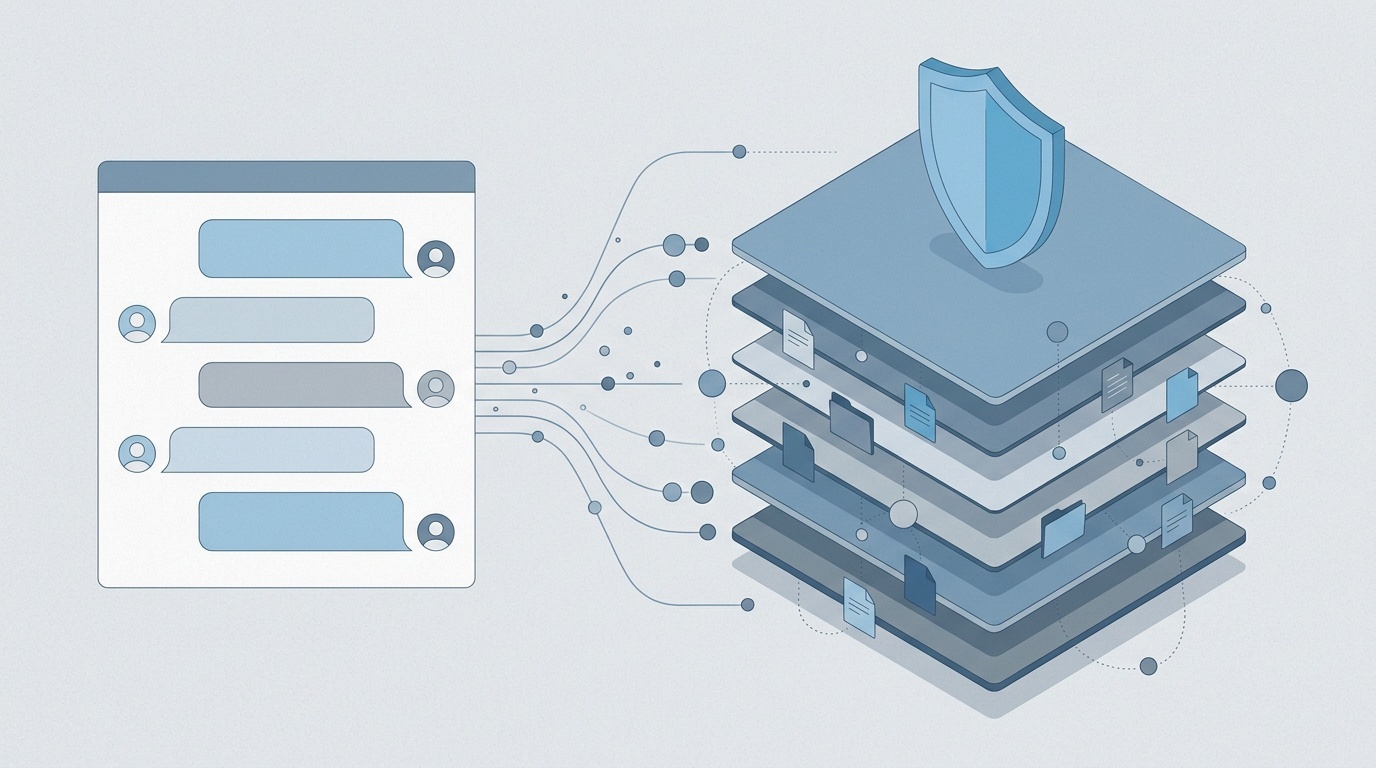
तीसरा approach pixel-level अर्थ में watermark नहीं है। यह file से जानकारी जोड़ता है: इसे किसने बनाया, कौन सा tool उपयोग हुआ, कौन से edits किए गए, और क्या credentials किसी trusted party द्वारा signed थे।
यहीं C2PA, Coalition for Content Provenance and Authenticity, आता है। C2PA content credentials को standardize करने का लक्ष्य रखता है ताकि images और अन्य media tools और platforms में signed provenance data साथ ले जा सकें।
यह approach watermark से अधिक expressive है। यह AI या not AI से अधिक बता सकता है। यह edits, sources, और chain of custody का वर्णन कर सकता है। लेकिन यह software support, signing parties पर trust, और metadata के attached बने रहने पर निर्भर करता है। जिसने भी image uploads से deal किया है, वह जानता है कि metadata अक्सर automatically strip हो जाता है। photos share करने से पहले EXIF metadata हटाने के पीछे वाली privacy instinct provenance systems को भी जटिल बनाती है।
वॉटरमार्किंग वास्तव में क्या करती है
वॉटरमार्किंग तब उपयोगी है जब आप उससे सही काम करवाते हैं।
1. यह ईमानदार disclosure का समर्थन करती है
AI-assisted visuals publish करने वाली teams के लिए, watermarking disclosure को अधिक consistent बना सकती है। कोई newsroom, marketplace, school, या design team generated images में visible labels, invisible marks, signed credentials, या इनके किसी combination की आवश्यकता रख सकती है।
यह bad actors को marks हटाने से नहीं रोकता। लेकिन यह उन organizations के भीतर ambiguity कम करता है जो responsible तरीके से व्यवहार करना चाहती हैं।
यह AI text के लिए editorial disclosure जैसा है। उपयोगी standard performative guilt नहीं; practical clarity है। यदि आपकी team synthetic assets का उपयोग करती है, तो कब और कैसे आप उनका disclosure करते हैं, यह समझाने वाली छोटी policy अस्पष्ट चिंता से अधिक उपयोगी है। यही सिद्धांत एक छोटी website पर ईमानदार AI disclosure पर भी लागू होता है: users को वह बताइए जो उनकी समझ को materially प्रभावित करता है।
2. यह platforms को moderation signal देता है
Platforms को scale पर signals चाहिए। Reliable watermark uploads को review के लिए route करने, labels लागू करने, ad policies enforce करने, या कुछ uses सीमित करने में मदद कर सकता है।
इसके लिए perfect accuracy की आवश्यकता नहीं है। Moderation system watermark detection को कई signals में से एक signal के रूप में उपयोग कर सकता है: account behavior, upload history, visual similarity, user reports, और content context।
खतरा signal को conclusive मानने में है। Detected watermark संकेत दे सकता है कि कोई image किसी particular generator से आई है। Missing watermark यह साबित नहीं करता कि image real है।
3. यह chain of custody को संरक्षित रखने में मदद करता है
Publishers, archives, legal teams, और researchers के लिए provenance सचमुच valuable हो सकता है। यदि कोई file creation से editing और publication तक signed credentials लेकर चलती है, तो बाद में reviewers समझ सकते हैं कि वह कैसे बदली।
यह खुले web पर हर fake image पकड़ने से कम, और trustworthy workflows बनाने से अधिक संबंधित है। Photo desk verify कर सकता है कि कोई image known camera से आई, approved editing software से गुज़री, और किसी particular editor द्वारा export की गई। Design team track कर सकती है कि कोई illustration generated, modified, licensed, और approved थी या नहीं।
C2PA-style credentials इन controlled environments में सबसे मजबूत होते हैं। वे तब कमजोर होते हैं जब कोई image unknown systems से copy होती है, screenshotted होती है, या बार-बार repost होती है।
4. यह deception की लागत बढ़ाती है
वॉटरमार्किंग deception को रोकती नहीं। यह deception को थोड़ा अधिक काम बना सकती है।
यदि कोई generator default रूप से robust invisible marks लागू करता है, तो synthetic images को camera originals की तरह पेश करने की कोशिश करने वाले व्यक्ति को अतिरिक्त laundering steps की आवश्यकता हो सकती है: editing, re-encoding, screenshotting, या marks के बिना models का उपयोग। ये steps quality को degrade कर सकते हैं, अन्य traces छोड़ सकते हैं, या operational friction बढ़ा सकते हैं।
यह glamorous नहीं है, लेकिन security अक्सर इसी तरह काम करती है। आप शायद ही abuse को पूरी तरह खत्म करते हैं। आप common abuse को धीमा, कम reliable, और investigate करने में आसान बनाते हैं।
यह क्या नहीं करती
Limitations वहीं हैं जहाँ teams आमतौर पर मुश्किल में पड़ती हैं।
यह साबित नहीं करती कि कोई image सच है
Real photograph भी misleading हो सकती है। Synthetic image स्पष्ट रूप से labeled होकर भी कुछ false communicate कर सकती है। Watermarking आपको origin या processing के बारे में बताती है, truth के बारे में नहीं।
किसी politician को कुछ fictional करते हुए दिखाने वाली labeled AI image अभी भी संभावित misinformation problem है। Deceptive caption वाली real photo भी misinformation problem है। Provenance मदद करता है, लेकिन interpretation अभी भी मायने रखती है।
यह attribution या copyright को हल नहीं करती
Generated by AI कहने वाला watermark यह नहीं बताता कि output किसी और के work का infringement करता है या नहीं, prompt में किसी living artist का नाम उपयोग हुआ था या नहीं, या training data ethically sourced था या नहीं।
ये अलग legal और ethical questions हैं। वे महत्वपूर्ण हैं, लेकिन उन्हें binary watermark में घटाया नहीं जा सकता।
यदि आपकी team public-facing work में generated images का उपयोग करती है, तो watermarking के साथ licensing review, source documentation, और necessity पर basic judgment भी होना चाहिए। Synthetic images की costs detection से आगे जाती हैं, जैसा कि open web पर AI-generated images की hidden cost में चर्चा की गई है।
यह हर transformation में जीवित नहीं रहती
Images को नियमित रूप से compressed, resized, transcoded, screenshotted, filtered, और reposted किया जाता है। कुछ systems common transformations को tolerate करने के लिए designed होते हैं। किसी के बारे में भी यह मानकर नहीं चलना चाहिए कि वह सभी transformations में survive करेगा।
Metadata खास तौर पर fragile होता है। कई social platforms, content management systems, messaging apps, और optimization pipelines file size घटाने या privacy protect करने के लिए metadata strip कर देते हैं। Pixel-level watermarks अधिक transformations में survive कर सकते हैं, लेकिन उन पर अभी भी attacks हो सकते हैं।
यह adoption के बिना काम नहीं करती
Provenance standard तभी उपयोगी है जब creation tools, editing tools, publishing systems, platforms, और viewers उसका support करें।
यह boring deployment problem है। यदि एक generator outputs mark करता है लेकिन दूसरा नहीं करता, तो detection coverage partial है। यदि editing software credentials drop कर देता है, तो chain टूट जाती है। यदि browsers और platforms credentials को स्पष्ट रूप से display नहीं करते, तो normal users उन्हें कभी नहीं देखते।
Watermarking केवल technical feature नहीं है। यह ecosystem agreement है।
AI images उपयोग करने वाली teams के लिए practical policy
अधिकांश organizations को forensic media labs बनने की आवश्यकता नहीं है। उन्हें workable rule set चाहिए।
एक sensible policy ऐसी दिखती है:
- Synthetic images को तब label करें जब उनकी synthetic प्रकृति interpretation को प्रभावित कर सकती हो।
- Published AI visuals के लिए source files, prompts, licenses, और approvals रखें।
- Provenance credentials या durable watermarking support करने वाले tools को प्राथमिकता दें।
- Missing watermarks को authenticity का proof न मानें।
- Documentary, evidentiary, medical, legal, या news-sensitive contexts में AI-generated images से बचें, जब तक कि बहुत स्पष्ट disclosure और review process न हो।
Marketing और product teams के लिए, सबसे common mistake malicious deception नहीं है। यह casual ambiguity है। जाहिर तौर पर illustrative hero image को fake product photo, fake customer portrait, या synthetic event image की तुलना में कम disclosure चाहिए। कोई image जितना अधिक viewer से यह विश्वास करने को कहती है कि वह real person, place, product, या event दिखाती है, आपका disclosure उतना ही मजबूत होना चाहिए।
Design teams को यह भी तय करना चाहिए कि disclosure कहाँ belong करता है। कभी-कभी visible labels appropriate होते हैं। कभी-कभी metadata और image credit पर्याप्त होते हैं। कभी-कभी सही उत्तर generated image का उपयोग न करना है।
Detection probabilistic होनी चाहिए, moralistic नहीं
Watermark detection signal है, verdict नहीं। यह महत्वपूर्ण है क्योंकि false confidence लोगों को नुकसान पहुँचा सकता है।
Detector heavy editing के बाद marked image miss कर सकता है। वह किसी image को गलत तरीके से flag कर सकता है। वह एक generator के लिए अच्छी तरह काम कर सकता है और दूसरे के लिए खराब। वह messy real-world distribution के बजाय lab conditions के लिए tuned हो सकता है।
इसलिए operational question यह नहीं होना चाहिए, क्या यह AI है? यह होना चाहिए, हमारे पास क्या evidence है, यह कितना reliable है, और हम इससे कौन सा decision ले रहे हैं?
कोई platform soft label जोड़ने का निर्णय लेते समय school द्वारा student पर misconduct का आरोप लगाने या publisher द्वारा fraud का आरोप लगाने की तुलना में अधिक uncertainty tolerate कर सकता है। Consequence जितना अधिक होगा, उतनी अधिक corroboration चाहिए।
यह वही caution है जो AI-content detection पर सामान्य रूप से लागू होती है: detectors triage के रूप में उपयोगी हैं, judges के रूप में नहीं।
सबसे अच्छा use case: trustworthy workflows, perfect policing नहीं
Watermarking के लिए सबसे मजबूत case हर synthetic image को internet में निकल जाने के बाद पकड़ना नहीं है। यह बहुत ambitious है।
मजबूत case publication से पहले trustworthy workflows बनाना है:
- Generator outputs mark करता है।
- Editing software credentials preserve करता है।
- Content management system उन्हें store करता है।
- Publisher relevant होने पर उन्हें display करता है।
- Reviewers बाद में chain inspect कर सकते हैं।
यह workflow हर bad actor को नहीं रोकेगा। यह responsible actors को अधिक legible बनाएगा।
यह distinction महत्वपूर्ण है। Watermarking को अक्सर misinformation के खिलाफ defensive wall के रूप में market किया जाता है। व्यवहार में, यह paper trail के अधिक करीब है। Paper trails valuable होते हैं। वे incomplete, lossy, और उन्हें maintain करने वाली institutions जितने ही trustworthy भी होते हैं।
<!-- tool-cta:start -->
💡 इसे आज़माएँ: यह देखने के लिए कि एम्बेड किए गए AI हस्ताक्षर कितने नाजुक हो सकते हैं, AI Metadata Masker आज़माएँ, जो दिखाता है कि ऐसे मार्कर कितनी आसानी से बदले या हटाए जा सकते हैं।
<!-- tool-cta:end -->
निष्कर्ष
AI-generated images की watermarking तीन उपयोगी काम करती है: यह disclosure का समर्थन करती है, platforms और publishers को moderation signal देती है, और controlled workflows में provenance preserve करने में मदद करती है।
यह truth साबित नहीं करती, copyright solve नहीं करती, attribution guarantee नहीं करती, या wild में हर synthetic image को reliably identify नहीं करती।
Practical stance न cynicism है, न blind trust। जहाँ यह ambiguity घटाती है, वहाँ watermarking का उपयोग करें। जहाँ chain of custody मायने रखती है, वहाँ standards-based provenance को प्राथमिकता दें। High-stakes uses के लिए human review रखें। और किसी technical marker को editorial judgment की जगह न लेने दें।
अक्सर पूछे जाने वाले प्रश्न
क्या AI image watermark हटाया जा सकता है?
क्या missing watermark साबित करता है कि image real है?
क्या C2PA watermarking जैसा ही है?
क्या websites को AI-generated images पर visible label लगाना चाहिए?
क्या AI watermark detectors enforcement के लिए पर्याप्त reliable हैं?
स्रोत और आगे की पढ़ाई